第 4 章/ 45
微积分:变化率、曲率与局部决策(Calculus for Quant)
主线:用价格对收益率的变化率和组合目标的局部曲率,把“变量动一点,结果会怎样”变成可检验的数学与计算。
先修:第 2 章 Python 与向量基础。本章在第 6.3 节逐步解释行列向量、转置和 2×2 矩阵乘法,不要求预先学完第 5 章;第 5 章再系统整理线性代数。完成后你能手算债券价格的一阶导数(first derivative)和二阶导数(second derivative),解释导数单位,使用梯度(gradient)和海森矩阵(Hessian matrix)检查二次目标(quadratic objective)的下降方向,并用数值差分(numerical differentiation)核验解析结果。
1. 本章目标
本章带你从一元变化率走到多变量局部近似。学完后,你应能:
- 从差商(difference quotient)的极限(limit)定义导数(derivative),并说明函数连续性(continuity)、可微(differentiable)和二阶连续可微(Twice Continuously Differentiable, C2)之间的关系;
- 根据输入输出单位解释导数,而不是只报告一个数字;
- 区分偏导数(partial derivative)、全微分(total differential)、梯度、方向导数(directional derivative)和 Hessian 矩阵;
- 从一阶与二阶 泰勒展开(Taylor Expansion)解释局部近似误差;
- 用微积分基本定理(Fundamental Theorem of Calculus)把边际变化累积成总变化;
- 判断一个驻点(stationary point)是局部极值(local extremum)中的局部极小(local minimum)、局部极大(local maximum)、鞍点(saddle point),还是二阶导数判别法(second derivative test)仍不能判断;
- 用中心差分(central difference)计算梯度与 Hessian,并与解析推导做数值对照。
验收以两个案例为准。债券价格、斜率和曲率的参考值为
P≈90.70295,P′≈−172.76752,P′′≈493.62148.组合案例应得到目标值 −0.0452、梯度 [−0.022,−0.038] 和 Hessian Σ。所有数字都来自明确写出的教学构造。
2. 为什么 Quant 需要它
你在做研究时经常要回答三类问题:收益率上升 1 个基点,价格大约动多少;某个特征改一点,预测分数往哪个方向变;策略权重微调后,风险目标是下降还是上升。微积分把这些问题拆成局部的斜率、方向和曲率。
直接把斜率当成价格变化会漏掉冲击大小:在本章的债券例子里,−172.77 表示每单位小数收益率的局部变化,1 个基点要再乘 0.0001。直接沿无约束梯度更新权重,也可能破坏满仓约束。本章分别用单位换算和可行方向检查这两类错误。
在多变量微积分(multivariable calculus)中,斜率回答“眼下往哪边走”;曲率回答“斜率如何变化”。优化器沿着斜率寻找改善方向,再借助曲率选择步长或判断目标面形状。定积分(definite integral)则把沿路径的边际变化累积起来,例如用价格对收益率的边际敏感度计算一段收益率变化对应的价格变化。
这些工具描述数学模型的局部行为,不能替代市场证据。一个导数算得很精确,也不会自动证明模型预测有效、交易能成交或成本可承受。
3. 直觉:先看坡度,再看弯曲
先读函数(function)记号。函数是一条把输入按规则变成输出的规则。P(y) 中,P 是价格函数,y 是输入的收益率,P(y) 是该收益率下的价格;换一个 y,规则不变,输出可以改变。比如 f(x)=x2 表示把输入 x 与自己相乘,输入 x=3 时输出 f(3)=9。这里 x 是自变量(independent variable),f(x) 是因变量(dependent variable)。
把函数 P(y) 想成一条曲线:横轴是收益率 y,纵轴是债券价格 P。在当前利率附近,用一条直线贴住曲线。直线的倾斜程度是一阶导数。若曲线向上弯,利率变动相同的两次价格反应不会完全相同;这种弯曲由二阶导数描述。
多变量目标 f(w1,w2) 像一张地形图。梯度指向上升最快的方向。梯度下降(gradient descent)沿负梯度寻找局部下降最快的方向。Hessian 描述各个方向的弯曲:碗口朝上时,目标在附近呈凸(convex)形;若一个方向向上弯、另一个方向向下弯,表面像马鞍。
这个地形类比只帮助看方向。它不表示金融目标一定全局凸,也不表示一步梯度更新符合预算、杠杆或空头约束。后文会把这些边界说清楚。
4. 数学基础:增量、单位与维度
4.1 先读变量、函数和指数
函数名后面的括号标出输入:f(x) 是函数 f 在输入 x 处的输出,不是 f 与 x 相乘。若有两个输入,g(x,z) 就把一对数映到一个输出。做变化率计算时,你先说明哪个输入在变、哪个输出随之变化;其余输入在偏导问题中保持固定。
指数(exponent)表示乘方:(1+y)2=(1+y)(1+y),而 a−2=1/a2(a=0)。所以两年期构造债券的折现式 100/(1+y)2 也可以写成 100(1+y)−2,负指数方便使用幂函数求导。这里收益率须满足 y>−1,使折现底数 1+y 为正。
4.2 输入增量与差商
设输入由 x 变成 x+h,函数值改变
Δf=f(x+h)−f(x).h 是输入的有符号增量,x+h 是新输入;Δf 是新旧输出之差。只要 h=0,比值
hf(x+h)−f(x)=hΔf就是这段输入区间上的平均变化率(average rate of change),单位为“输出/输入”。例如 f(x)=x2,从 x=2 增加 h=0.1:f(2)=4,f(2.1)=4.41,输出增加 0.41,平均变化率为 0.41/0.1=4.1。若 h=0.01,同样化简可得平均变化率 4.01。把 h 逐步缩小,差商趋近 4;h=0 时差商没有定义,极限研究的是非零 h 趋近于 0 的行为。
当 h 很小时,我们希望把变化写成“主要线性部分 + 更小的剩余部分”。若 f 在 x 可微,f(x)+f′(x)h 就是函数值的线性近似(linear approximation)。
f(x+h)−f(x)=f′(x)h+o(∣h∣).这里的 f′(x) 表示 x 处的导数,下一节用差商极限正式定义。
这里的 o(∣h∣) 表示余项除以 ∣h∣ 后在 h→0 时趋于 0。它比一阶增量更小,但没有告诉你余项一定按 h2 收敛;要得到更强的误差阶,需要更高阶的光滑条件。
4.3 单位与维度
导数的单位由输入和输出决定:
[导数]=[输出]/[输入].价格以货币计,收益率以小数无量纲记录,所以 P′(y) 的单位是“货币/单位小数收益率”。若价格单位是美元,导数就表示收益率小数增加 1.00 时的一阶价格变化约为多少美元。它不是“每一个百分比”的变化量。收益率变化 .01 是 1 个百分点,也就是 100 个基点;1 个基点是 .0001。
具体换算是:1 个百分点 =0.01,1 个基点是百分之一个百分点,所以 1bp=0.01/100=0.0001;25bp =25×0.0001=0.0025,100bp =0.01。
向量 w∈Rn 记录 n 个输入。若每个变量的单位不同,梯度各分量也有不同单位。矩阵 H∈Rn×n 的元素 Hij 单位为“函数单位 /(第 i 个输入单位 × 第 j 个输入单位)”。做优化时必须把坐标尺度和单位一起考虑。
把形状也写进检查:若 f:Rn→R,输入 w 是 n×1 列向量,函数值是标量,梯度 ∇f 是 n×1,Hessian 是 n×n。因此 ∇f⊤Δw 和 Δw⊤HΔw 都是标量。矩阵维度不匹配时,先检查向量是否用了行/列约定,不要靠转置到“能跑”为止。
5. 正式定义
极限描述 x 逼近某一点时函数值的趋近行为。若对每个 ε>0,都能找到 δ>0,使 0<∣h∣<δ 时有 ∣f(x+h)−L∣<ε,则 limh→0f(x+h)=L。
若 w=(w1,…,wn),偏导数 ∂f/∂wi 只改变 wi,把其余坐标固定。梯度把全部一阶偏导排成列向量:
∇f(w)=∂f/∂w1⋮∂f/∂wn.在可微点附近,全微分是线性主部:
df=∇f(w)⊤dw,f(w+Δw)−f(w)=∇f(w)⊤Δw+o(∥Δw∥).因此 df 是小变化的一阶近似,不是对任意有限变化都精确的等式。
给定单位方向 u,方向导数定义为
Duf(w)=h→0limhf(w+hu)−f(w).若 f 可微且 u 是单位向量,则 Duf(w)=∇f(w)⊤u。若 u 未归一化,这个数还乘着方向向量的长度;比较方向时应先统一长度。
Hessian 矩阵收集全部二阶偏导:
∇2f(w)=[∂wi∂wj∂2f(w)]i,j=1n.若 f 在邻域内二阶连续可微,混合偏导相等,Hessian 对称。对方向 u,二阶方向曲率为 u⊤∇2f(w)u。
Taylor 展开在点 w 附近用低阶多项式近似函数:
f(w+h)=f(w)+∇f(w)⊤h+21h⊤∇2f(w)h+R3(h).若 f∈C2,二阶展开中 R3(h)=o(∥h∥2);只保留到一阶项时,遗漏项是 21h⊤∇2f(w)h+o(∥h∥2),一般为 O(∥h∥2),不一定是 o(∥h∥2)。若 f∈C3,沿线段上的三阶导数有界,则可写成三阶拉格朗日余项(Lagrange remainder) R3(h)=61D3f(w+θh)[h,h,h],其中某个 θ∈(0,1)。这里的 D3f(z)[h,h,h] 表示在点 z 沿向量 h 的三阶方向导数;若其绝对值不超过 M∥h∥3,则 ∣R3(h)∣≤M∥h∥3/6。函数恰为二次多项式时,二阶展开没有三阶余项。
误差阶数描述步长缩小时余项怎样缩小。R(h)=O(∣h∣3) 表示在某个足够小的范围内,存在固定常数 C,使 ∣R(h)∣≤C∣h∣3;它不表示余项等于 h3。只保留切线项时,曲率项通常带来二阶误差;再加入二阶项,在三阶导数有界时,剩余误差才有三阶界。有限冲击能否接受,仍要把近似与精确值比较,并预先定好容忍度。
定积分(definite integral) ∫abg(x)dx 把小区间上的函数值乘以区间宽度,再累加并取极限,形成黎曼和(Riemann sum)。把区间 [a,b] 等分成 n 段、每段宽度 Δx=(b−a)/n,并在第 k 段选一个点 ξk,则
∫abg(x)dx=n→∞limk=1∑ng(ξk)Δx对连续的 g 成立。若 F′=g 且 g 连续,微积分基本定理给出
∫abg(x)dx=F(b)−F(a).在金融应用中,若 g 是单位输入的边际价格变化,积分结果就是价格变化,输入和输出单位会在乘积中抵消。
若可微函数在开放区域内取得局部极值,驻点的梯度必须为零。对在驻点邻域二阶连续可微的函数,驻点处 Hessian 正定(positive definite)可推出严格局部极小;负定(negative definite)可推出严格局部极大;不定(indefinite)矩阵可推出鞍点。半正定或半负定(positive or negative semidefinite)一般不能单独下结论。比如在原点,x4 是局部极小,−x4 是局部极大,x2−y4 是鞍点;三者的一阶导数都为零,Hessian 都是半定而非定。要判断这些点,必须检查更高阶项或直接沿不同方向分析函数值。约束边界上的极值不一定满足全空间梯度为零。
在开始逐步推导前,先掌握几条求导规则。若 f,g 在当前位置可微、a,b 为常数,则
(af+bg)′=af′+bg′,(fg)′=f′g+fg′,(f/g)′=(f′g−fg′)/g2(g=0).常数的导数为0,(xm)′=mxm−1 在该幂函数定义且可微的区域内成立;复合函数还需链式法则。a,b 是固定系数,m 是固定幂次,f′,g′ 是各自对同一输入的导数。不要把两个函数相乘的导数写成两导数相乘。
乘法规则可以直接从差商看出:在分子 f(x+h)g(x+h)−f(x)g(x) 中加减 f(x+h)g(x),分成 f(x+h)[g(x+h)−g(x)]+g(x)[f(x+h)−f(x)]。除以 h,利用可微推出连续,再取极限,得到 fg′+gf′。商法则可由乘法及 g−1 的导数推得。简单的 x2 则有差商 [(x+h)2−x2]/h=2x+h→2x。
偏导存在还不保证多变量可微。例 g(x,y)=xy/x2+y2 在原点以0定义:沿坐标轴两个偏导都为0,但沿 (t,t) 有 g(t,t)=∣t∣/2,相对于距离 2∣t∣ 的误差比为1/2,没有趋于0,因此不存在以零梯度为线性主部的全微分。偏导连续的 C1 条件是一个常用充分条件;后面的梯度近似不会仅凭“能算两个偏导”就成立。
6. 推导:从债券价格到组合曲面
6.1 一元导数与收益率单位
教学零息债的价格函数为
P(y)=(1+y)2100,y>−1.分母指数来自两年的年复利折现。先用幂函数求导法则(power rule):
P′(y)=100⋅(−2)(1+y)−3=−(1+y)3200.这一步同时用到链式法则(chain rule)。把外层写成 100u−2,内层为 u=1+y:外层对 u 的导数是 100(−2)u−3,内层对 y 的导数是 1,相乘得到
dydP=100(−2)(1+y)−3⋅dyd(1+y)=−200(1+y)−3⋅1.幂指数 −2 乘到前面的系数上,指数减 1;内层因子 d(1+y)/dy=1 不改变结果。
也可以完全回到定义核对第一步。令 a=1+y>0,则
hP(y+h)−P(y)=h(a+h)2a2100[a2−(a+h)2]=−(a+h)2a2100(2a+h)⟶−a3200.h 是收益率小数增量;化简时先消去公共因子 h=0,再取 h→0,没有直接除以零。这把幂函数规则与导数的差商定义接起来。
再求一次导数:
P′′(y)=(−200)⋅(−3)(1+y)−4⋅dyd(1+y)=(1+y)4600.这次外层的指数是 −3,所以系数变成 (−200)(−3)=600,指数变成 −4;链式法则的内层因子仍为 1。
对所有 y>−1,价格的一阶导数为负,二阶导数为正。在这条简化曲线上,收益率上升会降低价格;正曲率表示同样大小的收益率变化,其价格反应会随位置改变。这里的正曲率是公式的性质,不是对任何债券报价或实际收益率曲线的测量。
6.2 多变量链式法则(chain rule)与方向导数
若 y 又由时间 t 决定,复合函数 P(y(t)) 的导数为
dtdP=P′(y(t))dtdy.它把“价格对收益率的敏感度”乘以“收益率随时间的变化率”。若 t 按年计,dy/dt 的单位是小数收益率/年,最终 dP/dt 单位为价格/年。
这条路径固定剩余到期年数为2;t 是用“年”标记的情景路径参数,不能直接把结果当成同一债券随日历时间推移的完整价格导数。同一零息债实际会逐渐到期。若另写 P(y,τ)=100(1+y)−τ,其中 τ 是剩余到期年数,则沿真实时间还需要
dtdP=∂y∂Pdtdy+∂τ∂Pdtdτ,∂τ∂P=−Plog(1+y).这里平滑情景下 dτ/dt=−1。第一项反映收益率变化,第二项反映期限缩短;它们只在给定简化折现模型下成立,不计信用、交易或现金流事件。下方计算专门隔离第一项,便于练习链式法则。
把 y(t)=0.05+0.002t 当作一条教学路径,表示收益率每年增加 20bp。在 t=0,dy/dt=0.002,所以
dtdP=(−172.7675197063)(0.002)=−0.3455350394个价格单位/年。这不是对未来收益率的预测,只是把一条人为指定的收益率路径代入链式法则。
同一逻辑也适用于多个输入。令 g(x,z)=x2+3z,并设 x(t)=1+t, z(t)=2t。在 t=0,偏导为 gx=2x=2、gz=3,路径速度为 x′=1,z′=2,因此
dtdg=gxx′+gzz′=2(1)+3(2)=8.若走 dt=0.01,全微分预测 Δg≈8(0.01)=0.08。直接计算 g(1.01,0.02)−g(1,0)=0.0801。多出的 0.0001 来自 x2 的二阶项,不是链式法则错误。
以下片段用中心差分复核债券路径的导数,并比较全微分与有限变化。每个路径、输入和单位都在代码中明示:
face_value = 100.0
y0 = 0.05
yield_change_per_year = 0.002

def price(yield_rate: float) -> float:
    return face_value / (1.0 + yield_rate) ** 2

def yield_path(time_years: float) -> float:
    return y0 + yield_change_per_year * time_years

def price_path(time_years: float) -> float:
    return price(yield_path(time_years))

analytic_price_rate = (-200.0 / (1.0 + y0) ** 3) * yield_change_per_year
step_years = 1e-4
numeric_price_rate = (
    price_path(step_years) - price_path(-step_years)
) / (2.0 * step_years)

def g(x: float, z: float) -> float:
    return x**2 + 3.0 * z

g_rate = (2.0 * 1.0) * 1.0 + 3.0 * 2.0
dt = 0.01
exact_g_change = g(1.0 + dt, 2.0 * dt) - g(1.0, 0.0)
linear_g_change = g_rate * dt
print("bond price rate per year:", analytic_price_rate, numeric_price_rate)
print("g exact/linear change:", exact_g_change, linear_g_change)
assert abs(analytic_price_rate - numeric_price_rate) < 1e-8
assert abs(exact_g_change - 0.0801) < 1e-12
assert abs(linear_g_change - 0.08) < 1e-12
多变量情况下,沿曲线 w(t) 有
dtdf(w(t))=∇f(w(t))⊤dtdw.这也说明方向导数不是只看梯度大小:沿指定交易或风控方向,变化率由梯度与该方向的内积决定。
若 ∇f(w)=0,在欧氏长度为 1 的方向中,柯西–施瓦茨不等式(Cauchy–Schwarz inequality)给出最小方向导数 −∥∇f(w)∥2,取在 u=−∇f(w)/∥∇f(w)∥2 上。因此负梯度是单位欧氏步长下的最快局部下降方向;改用不同坐标尺度或距离度量后,“最快”方向也会随之改变。
几何上,先把当前位置沿单位向量 u 走一小段距离 h。复合函数 g(h)=f(w+hu) 的一元导数满足 g′(0)=∇f(w)⊤u。这就是链式法则把每个坐标变化贡献相加的结果。如果 u 不归一化,参数 h 代表的实际移动距离就不再是 h;方向导数数值也随向量长度缩放。
6.3 二次目标的梯度和 Hessian
定义教学目标
f(w)=21w⊤Σw−μ⊤w,Σ=[0.040.010.010.09],μ=[0.050.08].本例采用年频预期简单收益与年频协方差,统一用小数输入。目标一般写成
f(w)=2λriskw⊤Σw−μ⊤w.其中风险厌恶系数(Risk Aversion Coefficient)λrisk 决定方差与收益的相对权重,在保持收益单位解释时具有收益单位的倒数。这里固定该系数为1,省略其符号以专注求导;目标值是风险—收益评分,不是组合实际收益。若把小数改成百分数,必须同步转换系数,不能只换输入尺度。第9章详细讨论这一约定。这里,w 表示两项资产的组合权重向量(portfolio-weight vector),μ 是同一计量期间的预期收益向量(expected-return vector),Σ 是同期收益协方差矩阵(return covariance matrix),且为对称矩阵。对称矩阵满足
∇w(21w⊤Σw)=Σw,∇w(−μ⊤w)=−μ.所以
∇f(w)=Σw−μ,∇2f(w)=Σ.这里 w 是 2×1 列向量,w⊤ 是 1×2 行向量,所以 w⊤Σw 的形状依次为 1×2、2×2、2×1,最后得到标量。先乘一次矩阵:
Σw=[.04w1+.01w2.01w1+.09w2].再用 w⊤ 左乘,可见两个交叉项分别是 .01w1w2 和 .01w2w1;对称矩阵让它们相等。乘上目标里的 1/2 后,合并成 .01w1w2。
把矩阵乘法展开,目标为
f(w1,w2)=0.02w12+0.01w1w2+0.045w22−0.05w1−0.08w2.逐个坐标求偏导时先把另一个坐标固定:
∂w1∂f=0.04w1+0.01w2−0.05,∂w2∂f=0.01w1+0.09w2−0.08.例如,∂(.02w12)/∂w1=.04w1,而 ∂(.01w1w2)/∂w1=.01w2,因为求 w1 的偏导时 w2 固定。另一个坐标同理。
代入 w=(0.6,0.4),第一项为 .024+.004−.05=−.022,第二项为 .006+.036−.08=−.038。如果暂时增加 w1,第一项偏导回答目标怎样变;若同时调整两项权重,就把各坐标偏导乘各自增量后相加。
Hessian 是梯度对权重再求一次偏导的矩阵:
∇2f=[∂(∂f/∂w1)/∂w1∂(∂f/∂w2)/∂w1∂(∂f/∂w1)/∂w2∂(∂f/∂w2)/∂w2]=[.04.01.01.09].对角线刻画单个权重方向的曲率,非对角的 .01 刻画两个权重同时改变时的交互曲率。沿任一小方向 d,二阶变化由 21d⊤Σd 给出;这里 Σ 正定,所以除零方向外该项都为正。
取一个保持满仓的方向 Δw=(−.01,.01),也就是从资产 1 转 1 个百分点到资产 2。梯度项为 (−.022)(−.01)+(−.038)(.01)=−.00016,曲率项为 21Δw⊤ΣΔw=.0000055。该二次目标的 Taylor 展开没有更高阶余项,所以实际目标变化恰为 −.0001545。权重从 (.60,.40) 变成 (.59,.41),预算仍为 1,目标确实下降。
若 Σ 不对称,二次型的梯度会包含其对称部分 (Σ+Σ⊤)w/2;本章的协方差矩阵满足对称条件。
6.4 定积分怎样累积价格变化
对 y∈[0.05,0.06],债券价格变化可以由边际价格变化积分得到:
P(0.06)−P(0.05)=∫0.050.06P′(y)dy.这里取 F=P,因为 P′=dP/dy,且在区间上 P′ 连续;微积分基本定理把边际变化的累积改写为端点之差。代入端点得到 88.9996440014−90.7029478458=−1.7033038444。被积函数单位是价格/收益率单位,积分变量单位是收益率,所以结果回到价格单位。这一步是同一条构造公式的精确累积,不是说 P′(0.05)×0.01 对有限区间也精确。
积分结果为负,表示沿收益率从 5% 增加到 6% 时价格净下降,不表示价格本身为负。交换积分上下限,符号会反转,表示从 6% 回到 5% 的价格增量。把区间切得更细时,黎曼和用更多局部边际值累积同一段总变化。
6.5 中心差分怎样近似导数
解析求导要知道公式。数值差分只需能在输入点附近计算函数值。对平滑的一元函数,在点 x 取相同距离 h 的左右值:
f(x+h)=f(x)+f′(x)h+21f′′(x)h2+O(h3),f(x−h)=f(x)−f′(x)h+21f′′(x)h2+O(h3).两式相减并除以 2h,偶次项抵消:
f′(x)≈2hf(x+h)−f(x−h).在相应光滑条件下,截断误差(truncation error)是 O(h2)。但 h 不能无限缩小:浮点运算(floating-point arithmetic)会因相近数相减而损失有效数字。多变量梯度逐坐标做中心差分;Hessian 对角线用二阶中心差分,非对角项用四点中心差分。数值结果会受步长、尺度、噪声和边界共同影响。
选步长时会遇到两种误差拉扯:步长大,函数曲线在区间内的弯曲让差商偏离当前位置斜率;步长太小,计算机相减两个几乎相同的函数值时会放大舍入影响。遇到带噪声的模拟或随机目标,过小步长还可能把估计噪声除以很小的数。实务上可以对一组相邻步长重复估计,检查结果是否形成稳定区间;若只有一个步长给出理想答案,应先怀疑差分设置。接近参数边界时,中心差分还可能访问非法输入点,需要显式处理边界或采用可解释的一侧方法。
6.6 下降方向怎样变成有限一步
负梯度的方向导数为负,并不表示任意步长都下降。先在已有二次目标中精确计算。记当前梯度为 g=Σw−μ=0,沿 wnew=w−ηg 移动,η>0。把增量 −ηg 代入本例无余项的二阶式,得到
f(w−ηg)−f(w)=−ηg⊤g+2η2g⊤Σg.第一项随步长线性下降,第二项随步长平方增加。Σ 正定且 g=0 时,g⊤Σg>0,因此严格下降恰好要求
0<η<g⊤Σg2g⊤g.在本章 w=(.6,.4)⊤、g=(−.022,−.038)⊤ 处,g⊤g=.001928,g⊤Σg=.00016604,上界约为 23.22332。中间值可逐格核对:
Σg=(−.00126,−.00364)⊤,g⊤g=.000484+.001444=.001928,g⊤Σg=.00002772+.00013832=.00016604.起始目标为 −.0452;η=.1 的目标变化为 −.0001919698;换成 η=30,变化为 +.016878,新目标 −.028322 比起点更高。上界处变化为零,不是严格下降。梯度为零时,这条更新不动,不能通过除以零套用上界。
这个精确上界只属于当前固定二次目标;一般可微函数需要检查足够小的步长、局部曲率或按明确规则回溯,不能直接沿用本例数值。即使 η=.1 下降,新权重和仍是 1.006,所以没有通过预算验收。按已有可行方向 d=(−1,1)⊤,从 (.6,.4) 走到 w+sd 会保留预算;长仓要求 0≤s≤.6,而 s=.01 的精确目标变化仍为 −.0001545。下降与可行需要分别核对,不能用一种检查代替另一种。
7. 金融解释:敏感度不等于收益预测
债券案例的 P′(y) 说明公式价格对收益率的小幅变化有多敏感;它不是收益率方向预测,也不是已经实现的交易盈亏。若把收益率冲击 0.0001 代入,一阶价格变化近似为 P′(y)×0.0001。这里必须先确认利率以小数录入,再乘以正确的冲击。
在组合目标中,若 μ 表示同一频率的预期收益向量,梯度的第 i 项表示把第 i 个权重增加一个单位、暂时固定其余权重时,目标的一阶变化率。负梯度给出无约束局部下降方向。Hessian 的正定性意味着所有非零小方向上二阶曲率为正;在全局二次目标中,若 Σ≻0,目标是严格凸的,存在唯一无约束极小点。
投资组合有预算约束 1⊤w=1、不卖空约束 wi≥0、杠杆或行业限制时,完整梯度步可能离开可行集合。需要投影、约束优化或拉格朗日乘子(Lagrange multiplier);本章的梯度下降示例只说明局部数学,不代表完成了可执行组合构建。
第 8.2 节的无约束一步把权重和推到 1.006,目标虽下降,却不满足满仓条件。第 6.3 节从 (.60,.40) 向 (.59,.41) 转移权重,增量之和为 0,所以那一步保留预算等式;可行方向检查把约束带回局部改进判断。
这时只允许沿可行方向移动。若只考虑预算等式,微小方向 d 必须满足 1⊤d=0;若某个权重已经为零,长仓约束还要求该坐标的 di≥0。边界局部最小点的一阶必要条件是:所有可行方向上的一阶变化都不下降,因此全空间梯度可以不为零。这项必要条件单独不能保证最优,还要检查目标曲率或更高阶变化。拉格朗日乘子把约束的边际放宽与最优目标值的边际变化联系起来;符号取决于你把约束写成 1⊤w−1=0 还是 1−1⊤w=0。
本章给定的 f(w)=21w⊤Σw−μ⊤w 是便于看清梯度与曲率的教学目标。按金融量纲,协方差项和均值收益项的量纲并不天然相同。实际均值方差目标(mean-variance objective)通常会加上风险厌恶系数(risk-aversion coefficient)或采用明确归一化,使两项能够有意义地权衡;本章系数按数值目标定义固定,不能直接解释成某个投资者的效用或风险偏好。
8. Numerical Example:逐项手算并检查
8.1 零息债价格和 1 个基点
在 y=0.05 时:
P(0.05)=1.052100=90.7029478458,P′(0.05)=−1.053200=−172.7675197063,P′′(0.05)=1.054600=493.6214848751.价格单位是货币单位。小数收益率提高 .0001,一阶近似为
ΔP≈−172.7675197063×0.0001=−0.01727675197.提高 .01 是 100 个基点,一阶近似为 −1.7276751971,不是 1 个基点。真实代入同一构造公式,P(0.06)=88.9996440014,所以精确变动为 −1.7033038444。两者不同,因为 .01 对这条曲线来说不是无穷小。
二阶 Taylor 近似把曲率项加回来:
P(0.06)≈P(0.05)+P′(0.05)(.01)+21P′′(0.05)(.01)2=88.9999537230.线性项贡献 −1.7276751971 个价格单位;曲率项贡献约为 +0.0246810742,因此二阶近似的价格变动为 −1.7029941228。以精确变动减去二阶近似变动,误差约为 −0.000309722,绝对误差约为 0.000309722。正的二阶导数使利率上升时的下降幅度小于切线预测;若收益率向下变动,二阶修正仍为正,会让价格上升幅度大于切线预测。对更小的收益率冲击,局部近似通常更贴近;是否足够精确要看你的误差容忍度和模型条件。
下面代码独立定义输入、公式和断言,可在项目冻结环境运行。数值差分函数来自本地项目包:
import numpy as np
from quant_course.math_tools import finite_difference_gradient, finite_difference_hessian

face_value = 100.0
y = 0.05

def bond_price(point: np.ndarray) -> float:
    return face_value / (1.0 + point[0]) ** 2

price = bond_price(np.array([y]))
analytic_first = -2.0 * face_value / (1.0 + y) ** 3
analytic_second = 6.0 * face_value / (1.0 + y) ** 4
numeric_first = finite_difference_gradient(bond_price, [y], step=1e-4)[0]
numeric_second = finite_difference_hessian(bond_price, [y], step=1e-3)[0, 0]

print(f"price={price:.10f}")
print(f"first analytic/numeric={analytic_first:.10f}/{numeric_first:.10f}")
print(f"second analytic/numeric={analytic_second:.10f}/{numeric_second:.10f}")
assert np.isclose(price, 90.7029478458)
assert np.isclose(analytic_first, numeric_first, rtol=1e-6)
assert np.isclose(analytic_second, numeric_second, rtol=2e-6)
8.2 二次曲面的下降方向
取
w=[.6.4],Σw=[.04(.6)+.01(.4).01(.6)+.09(.4)]=[.028.042].因此
∇f(w)=[.028.042]−[.05.08]=[−.022−.038].先算二次项:w⊤Σw=.6(.028)+.4(.042)=.0336,再算 μ⊤w=.05(.6)+.08(.4)=.062。所以
f(w)=21(.0336)−.062=−.0452,∇2f(w)=Σ.矩阵 Σ 的左上主子式是 0.04>0,行列式是 0.04(0.09)−0.012=0.0035>0,因此它正定,曲面朝上弯。
取学习率(learning rate) η=0.1,一次无约束梯度下降步(gradient-descent step)为
wnew=w−η∇f(w)=[.6022.4038].计算得到 f(wnew)=−0.0453919698,比起点更低。这只检查了这个具体小步;步长过大时目标可能上升。注意新权重之和是 1.006,所以它不满足满仓约束。
项目函数用中心差分计算梯度与 Hessian。代码将解析值、数值值和一次下降步放在同一处:
import numpy as np
from quant_course.math_tools import finite_difference_gradient, finite_difference_hessian

sigma = np.array([[0.04, 0.01], [0.01, 0.09]])
mu = np.array([0.05, 0.08])
weights = np.array([0.6, 0.4])

def objective(point: np.ndarray) -> float:
    return float(0.5 * point @ sigma @ point - mu @ point)

exact_gradient = sigma @ weights - mu
numeric_gradient = finite_difference_gradient(objective, weights)
numeric_hessian = finite_difference_hessian(objective, weights)
next_weights = weights - 0.1 * exact_gradient

print(f"f={objective(weights):.10f}")
print("gradient:", exact_gradient)
print("numeric gradient:", numeric_gradient)
print("numeric Hessian:\\n", numeric_hessian)
print("one unconstrained step:", next_weights)
print(f"new objective={objective(next_weights):.10f}")
assert np.isclose(objective(weights), -0.0452)
assert np.allclose(exact_gradient, [-0.022, -0.038])
assert np.allclose(numeric_hessian, sigma, atol=2e-7)
assert objective(next_weights) < objective(weights)
9. Python Implementation:用解析式校验数值差分
默认读者包入口(承接接受I3)
从读者安装说明建立环境,在读者包根运行:
.venv/bin/python run_notebook.py notebooks/ch04_calculus.ipynb
默认Notebook调用随包共享实现,不读取未随包提供的French数据、不下载数据;新运行和图写入唯一runs子目录。读者CLI使用UUID目录并拒绝覆盖。未随包提供的旧测试位置只是原制作验收记录;读者使用Notebook内断言。French输入仅按可选数据契约提供,本批未重跑。下面保留原课程根脚本路线,与读者包入口分别使用各自环境。
完整脚本位于 ch04_calculus.py,可复跑 Notebook 位于 ch04_calculus.ipynb,核心函数位于 src/quant_course/math_tools.py。在项目根目录按 冻结环境说明 安装后运行:
.venv/bin/python tools/run_a2.py --chapter 4
这章脚本使用确定性的构造公式,没有随机种子、市场数据或时间序列频率。没有 signal timestamp、trade timestamp 或实测收益区间。若将同样计算用于策略,先确认输入数据在 signal_time 可用,再把 trade_time 放在信号之后,并明确收益区间从实际持仓生效时开始。
中心差分梯度应用程序接口(Application Programming Interface, API)如下:
finite_difference_gradient:参数为可调用标量函数、有限非空实数向量和步长。默认步长为 1e-5;返回与输入向量等长的浮点向量。finite_difference_hessian:参数含义相同,默认步长为 1e-4;返回长度等于输入维度的方阵。
函数必须在差分涉及的每个点返回有限实数标量。输入函数或向量出现 NaN、无穷值、复数或非数值类型时,接口明确报错,不会替你补值。默认步长由所有坐标共享,需要按输入尺度检验稳定性。
这两个函数用中心差分:梯度每次只扰动一个坐标;Hessian 的对角项用 [f(x+h)−2f(x)+f(x−h)]/h2,交叉项用四点混合差分。选步长时要按变量尺度和函数精度做敏感性检查;默认值是接口起点,不是金融市场通用常数。想评估数组网格上的采样函数,可以用 NumPy 的 gradient,它对内部点使用中心差分、边界使用单边差分,并保留输入数组形状。这里把时间坐标明确传给函数,避免默认把每个观测间距当成 1:
import numpy as np

time_years = np.array([0.0, 0.4, 1.0, 1.8, 3.0])
values = time_years**2
estimated_slope = np.gradient(values, time_years)
print("time in years:", time_years)
print("sampled function:", values)
print("estimated derivative:", estimated_slope)
assert np.isclose(estimated_slope[2], 2.0)
10. Visualization:误差阶数和浮点底线
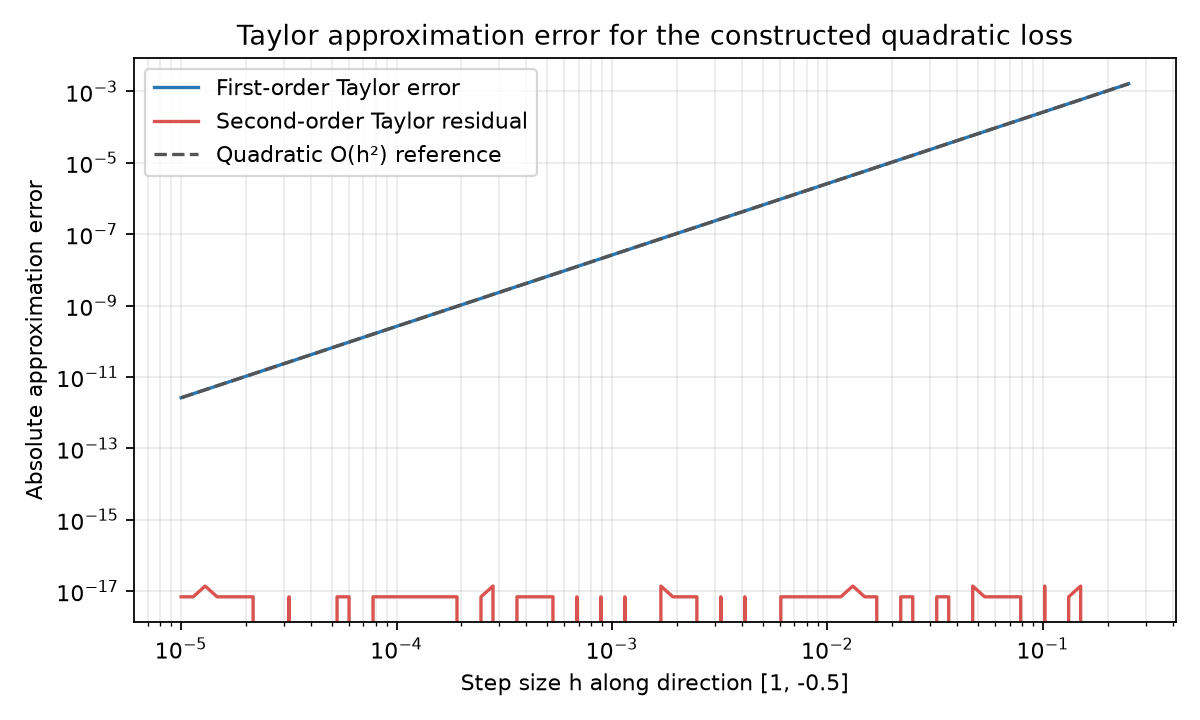
图由脚本在构造二次目标上生成。横轴是沿方向 [1,−0.5] 的步长 h,使用对数刻度;纵轴是目标评分的绝对近似误差,沿用该目标的评分尺度;它不是实现收益率或市场价格误差。蓝线表示一阶 Taylor 近似误差,虚线给出二次量级 O(h2) 参照。红线表示二阶近似残差。因为目标本身是二次函数,精确算术下二阶式没有更高阶余项;数值残差降到浮点舍入的量级后便不再按理论幂次下降。
读图时比较曲线斜率和平台区,不要把平台误认为真实目标函数的结构,也不要把这张误差图解释成债券收益率曲线或实测市场价格。代码输出的债券数值与图形分别服务于手算核对和近似误差演示。
11. Real Market Example:构造例子和市场观测的边界
本章没有下载或分析真实市场价格、收益率曲线或债券现金流,因此没有实证样本期、市场频率、数据授权、版本哈希或真实市场结论。第 8 节的面值 100、两年期限和 5% 年复利收益率是为了让你能逐步手算的教学构造,不能引用为某天市场观测。
在真实固定收益研究中,建模前至少要记录证券身份、票息与现金流日期、日计数、收益率复利口径、净价或全价、曲线来源、时间戳和数据版本。实际现金流往往要逐期贴现,不一定能用单一到期收益率和单一折现因子概括。收益率曲线变化、信用利差变化、流动性和应计利息也会改变实时报价。后续金融章节再讨论久期、凸性与市场数据;本章的 P′(y)、P′′(y) 只解释当前简化公式。
要把示例升级成经验研究,还需写下目标证券如何选取、报价观察时间和收益率如何匹配、重复报价和缺失值如何处理、报价是否包含应计利息、现金流日期如何映射到曲线节点。拟合出一个局部斜率后,还要用另一个时间段或另一组证券检查它的稳定性。没有这些记录,公式推导只能说明“若模型成立会怎样”,不能证明市场实际如何变化。
12. Common Mistakes:常见误读
错误一:把 1 个基点当成 .01
收益率字段若按小数存储,1 个基点是 0.0001。下面片段把 100 个基点的变化误写成 1 个基点。若断言两种影响相同,断言会失败;下方用否定断言展示差异。正确做法用 .0001:
import numpy as np

y = 0.05
dy_wrong = 0.01
dy_one_bp = 0.0001
price = lambda rate: 100.0 / (1.0 + rate) ** 2

wrong_change = price(y + dy_wrong) - price(y)
one_bp_change = price(y + dy_one_bp) - price(y)
print(f"wrongly labeled one bp: {wrong_change:.10f}")
print(f"actual one bp: {one_bp_change:.10f}")
assert not np.isclose(dy_wrong, dy_one_bp)
assert np.isclose(one_bp_change, -0.0172742842, atol=1e-10)
精确的一基点变化是 −0.0172742842 个价格单位;.01 实际代表 100 个基点,精确价格变化约为 −1.7033038444。
错误二:用前向差分却漏掉括号
错误三:把二阶公式当成任意函数的精确恒等式
Taylor 二阶式只有在保留余项或具有适当的函数形式时才精确。对 ex,在 0 点用二阶多项式估计 e0.5:
import math

x = 0.5
approximation = 1.0 + x + x**2 / 2.0
exact = math.exp(x)
error = exact - approximation
print(f"quadratic approximation={approximation:.10f}")
print(f"exact value={exact:.10f}")
print(f"omitted remainder={error:.10f}")
assert error > 0.0
近似值为 1.625,真值约为 1.6487212707,被遗漏的高阶项约为 0.0237212707。二阶近似可以支持局部估算,不会自动变成全局精确公式。
错误四:只看梯度为零就宣布找到最小值
f(x,y)=x2−y2 在原点梯度为零,但沿 x 方向上升,沿 y 方向下降;原点是鞍点。检查 Hessian 的正负方向,而不是只看一阶条件。
下面先用错误规则把驻点判作最小,再用 Hessian 特征值和两个方向的小步检查修正:
import numpy as np

def saddle(point: np.ndarray) -> float:
    return float(point[0] ** 2 - point[1] ** 2)

origin = np.array([0.0, 0.0])
gradient = np.array([2.0 * origin[0], -2.0 * origin[1]])
hessian = np.array([[2.0, 0.0], [0.0, -2.0]])
wrongly_called_minimum = np.allclose(gradient, 0.0)
eigenvalues = np.linalg.eigvalsh(hessian)
rise = saddle(np.array([0.1, 0.0])) - saddle(origin)
fall = saddle(np.array([0.0, 0.1])) - saddle(origin)
print("gradient:", gradient, "naive minimum label:", wrongly_called_minimum)
print("Hessian eigenvalues:", eigenvalues, "directional changes:", rise, fall)
assert wrongly_called_minimum
assert eigenvalues[0] < 0.0 < eigenvalues[1]
assert rise > 0.0 and fall < 0.0
错误五:把 unconstrained 梯度步当成可行组合
第 8.2 节的一步得到 [0.6022,0.4038],权重和为 1.006。目标下降并不代表预算约束仍成立。先声明约束,再使用可行方向或投影算法。
下面保留错误的无约束一步作比较,再沿保持权重和为 1 的方向做小步:
import numpy as np

sigma = np.array([[0.04, 0.01], [0.01, 0.09]])
mu = np.array([0.05, 0.08])
weights = np.array([0.6, 0.4])

def objective(point: np.ndarray) -> float:
    return float(0.5 * point @ sigma @ point - mu @ point)

gradient = sigma @ weights - mu
unconstrained = weights - 0.1 * gradient
feasible_direction = np.array([-1.0, 1.0])
feasible = weights + 0.01 * feasible_direction
print("unconstrained weights/sum:", unconstrained, unconstrained.sum())
print("feasible weights/sum:", feasible, feasible.sum())
print("starting/feasible objective:", objective(weights), objective(feasible))
assert not np.isclose(unconstrained.sum(), 1.0)
assert np.isclose(feasible.sum(), 1.0)
assert np.all(feasible >= 0.0)
assert objective(feasible) < objective(weights)
错误六:用不同单位的坐标比较梯度大小
若一个特征以“百分点”计,另一个以“比例”计,未经缩放的梯度模长会混合量纲。先统一尺度,或明确变换如何改变梯度、步长及 Hessian。缩放会改变数值优化的路径,不会改变所定义经济问题本身。
价格对小数收益率的导数约为 −172.77 个价格单位/小数单位,换成“每 1bp”的坐标后导数约为 −0.01728 个价格单位/bp。两者差一万倍,只反映坐标单位换了;同一个 1bp 冲击乘上对应导数,影响相同。
import numpy as np

y = 0.05
one_basis_point_in_decimal = 0.0001
price = lambda rate: 100.0 / (1.0 + rate) ** 2
derivative_per_decimal = -200.0 / (1.0 + y) ** 3
derivative_per_basis_point = derivative_per_decimal / 10000.0
impact_from_decimal_coordinate = derivative_per_decimal * one_basis_point_in_decimal
impact_from_bp_coordinate = derivative_per_basis_point * 1.0
print("derivative per decimal unit:", derivative_per_decimal)
print("derivative per basis point:", derivative_per_basis_point)
print("same shock impact:", impact_from_decimal_coordinate, impact_from_bp_coordinate)
assert np.isclose(impact_from_decimal_coordinate, impact_from_bp_coordinate)
错误七:链式法则漏乘路径速度
P′(y) 的单位是“价格/收益率”,而沿 y(t) 的 dP/dt 单位是“价格/时间”。直接把两者当成同一个数,会漏掉 dy/dt。若收益率每年上升 20bp,路径速度是 0.002 小数单位/年:
import numpy as np

y = 0.05
yield_change_per_year = 0.002
derivative_price_per_yield = -200.0 / (1.0 + y) ** 3
wrong_price_rate = derivative_price_per_yield
correct_price_rate = derivative_price_per_yield * yield_change_per_year
print("wrong units/value:", wrong_price_rate, "price per yield unit")
print("chain-rule rate:", correct_price_rate, "price per year")
assert not np.isclose(wrong_price_rate, correct_price_rate)
assert np.isclose(correct_price_rate, -0.3455350394)
13. Quant Research Application:把局部计算接到可检验决策
假设你在评估一个组合调整,目标函数包括风险惩罚与预期收益项。先写明符号、数据频率和估计窗口,再计算 f(w)、梯度和 Hessian。用方向导数检查候选调整 d:若 ∇f(w)⊤d<0,只说明在足够小的步长下,目标的一阶变化下降。二阶项 d⊤Hd/2 可以提示曲率是否会改变有限步长的结果。
可复核流程是:第一,从训练窗口估计 μ 与 Σ,只使用在 signal_time 前已可用的数据;第二,写出预算、杠杆、空头、行业和换手约束;第三,比较解析导数与数值差分,并对参数尺度和步长做检查;第四,把候选权重投影到可行集合或交给约束优化器;第五,使用晚于 signal_time 的 trade_time 和明确的收益区间计算样本外(out-of-sample)净收益;第六,纳入交易成本、融资、借券和组合漂移,与简单基准比较。
反证条件也要预先写明:若差分与解析结果对不上、梯度步长稍改便翻转、可行解经常触碰不现实约束、成本后优势消失,或样本外结果不优于预先选定的基准,就不能把局部数学改善表述成策略有效。
14. Chapter Summary
导数把小输入变化映射为一阶输出变化;梯度把多维斜率排在一起;Hessian 记录方向曲率;Taylor 公式把斜率与曲率组合成局部近似;定积分把边际变化累积为有限变化。每个结论都有条件,尤其是平滑性、坐标尺度和约束集合。
做金融计算时,你需要把数学和单位放在一起检查:小数收益率的 1bp 是 .0001,梯度的含义取决于输入坐标单位,而负梯度更新并不会自动满足仓位约束。解析计算可解释结构,数值差分可帮助发现实现错误,两者一致仍需配合真实数据、时序可得性和交易成本检验。
15. Exercises
4-N01 识别:函数、输入与差商
令 q(x)=2x2+1。指出自变量和因变量,解释指数 2 表示什么。输入从 x=2 变到 x+h=2.1 时,依次计算 h、q(2)、q(2.1)、输出变化 Δq 和差商 Δq/h。最后说明差商回答什么问题。
4-N02 演算:债券导数与基点
对 P(y)=100(1+y)−2,令 u=1+y,逐步用幂函数求导和链式法则求出 P′(y)、P′′(y)。在 y=0.05 代入并保留 4 位小数。若收益率上升 25bp,先写成小数增量,再计算一阶价格变化近似,并给出导数与变化的单位。
4-N03 代码诊断:斜率还是价格变化
某同学想输出 1bp 的价格变化,写了下面代码。指出变量名与计算值之间的问题,并把输出改成一阶近似价格变化;再用函数值之差核对。
def price(y):
    return 100.0 / (1.0 + y) ** 2

y = 0.05
one_bp = 0.0001
reported_price_change = (price(y + one_bp) - price(y)) / one_bp
assert abs(reported_price_change + 172.7675) < 0.1
4-N04 研究判断:局部公式能说明什么
研究者把 P′(0.05)=−172.7675 用作“收益率明天会上升”的证据,并据此声称真实债券明天会跌约 0.0173 个价格单位。分别判断这两个结论能否由本章构造公式推出。若要报告真实债券对 1bp 冲击的价格敏感度,还需要先记录哪些模型、报价和时间信息?
4-E01 概念:可微与连续
说明“可微必连续”是什么意思,并给出一个在某点连续但不可微的函数。指出它在哪一点、左右差商为何不同。
4-E02 概念:收益率冲击单位
某利率字段存为小数。分别写出 1bp、25bp、100bp 对应的小数变化。若一个程序把 1bp 写成 .01,它实际用了多少基点?
4-E03 数学:价格斜率
从 P(y)=100/(1+y)2 推出 P′(y),并解释 P′(0.05) 的符号、数值和单位。它能否预测明天的收益率方向?
4-E04 数学:全微分与链式法则
设 g(x,z)=x2+3z,且 x(t)=1+t, z(t)=2t。求在 t=0 处的 ∂g/∂x、∂g/∂z、dg/dt,并用链式法则核对。
4-E05 概念:单位方向
解释为什么比较两个方向的方向导数时,通常要把方向向量归一化。若 u=(1,1),单位方向是什么?
4-E06 数学:梯度与 Hessian
对 q(x,y)=x2+xy+2y2,求梯度和 Hessian。判断 Hessian 正定,并解释这对驻点的含义。
4-E07 概念:Taylor 误差
二阶 Taylor 公式中的三阶拉格朗日余项(Lagrange remainder)需要什么类型的光滑性?若函数本身是二次多项式,会发生什么?
4-E08 数学:驻点分类
给出三个二维函数分别在原点具有局部极小、局部极大和鞍点,并用梯度和 Hessian 说明。
4-E09 数学:微积分基本定理
计算 ∫012xdx,分别用原函数和“边际变化累积”的语言解释结果。
4-B01 方向与有限步长
沿第6.6节的现有二次目标,从 w=(.6,.4)⊤ 做负梯度一步。推导精确目标增量和严格下降的步长区间;比较 η=.1 与 30,并核权重和。若改沿 d=(−1,1)⊤ 走 s 步,预算及长仓允许哪些 s≥0?为什么目标下降仍不能证明真实投资收益改善?
16. Programming Exercises
4-P01 债券差分核验
输入:教学函数 P(y)=100/(1+y)2、y=0.05。用解析式和项目中心差分函数计算一阶、二阶导数;一阶导数使用 h=10−4,二阶导数使用 h=10−3。输出差值,并断言二者与解析值在合理误差内。明确 1bp 与 100bp 的价格变化单位。
4-P02 二次目标
输入本章 Σ,μ,w。计算 f(w)、解析梯度、数值梯度、数值 Hessian 和一次学习率 0.1 的无约束梯度步。断言目标下降,并报告新权重之和。解释为什么这不等于求得可行投资组合。
4-P03 采样导数与积分
在非均匀节点 x=[0,0.4,1.0,1.8,3.0] 上采样 g(x)=x2。用 NumPy 的 gradient 并传入实际节点,检查内部点导数;用中点求积(midpoint rule)近似 ∫01x2dx,每次把区间等分为 10、100、1000 份,说明近似误差如何变化。
17. Challenge Problems
4-C01 用曲率选择收益率冲击的近似
对本章债券价格,从 y=.05 开始,分别研究 1bp、25bp、100bp 上升的精确价格变化、一阶近似和二阶近似。说明在哪些步长下局部误差可接受,并写出你选用的容忍阈值。讨论浮点误差和模型误差的区别。此题没有唯一阈值,但必须给出可重复的判断规则。
评分共 10 分:单位与冲击正确 2 分;精确值和两阶近似核对 3 分;误差/容忍标准 2 分;解释小步与大步差异 2 分;明确教学公式不代表真实市场观测 1 分。
4-C02 把二次目标改成满仓组合
求解
wmin 21w⊤Σw−μ⊤w满足1⊤w=1,w≥0.先说明为什么无约束驻点 Σ−1μ 不能直接作为满仓答案;再推导仅有预算等式约束且不设非负约束时的解;最后描述增加 w≥0 后需要检查哪些边界候选。给出可复现数值结果或完整枚举步骤,并说明数值优化器还需要哪些验收。
评分共 12 分:无约束解与约束冲突 2 分;拉格朗日推导 3 分;非负约束边界分析 3 分;数值/解析结果 2 分;优化器可行性与目标核验 2 分。若只给库函数输出,没有约束与结果核验,最多得 4 分。
18. Solutions / Solution Hints
4-N01 答案
x 是自变量,q(x) 是因变量。指数 2 表示 x⋅x。由 x=2 变到 2.1,h=0.1,且
q(2)=2(22)+1=9,q(2.1)=2(2.12)+1=9.82.所以 Δq=9.82−9=0.82,差商是 0.82/0.1=8.2,单位为“q 的单位/x 的单位”。它是区间 [2,2.1] 上的平均变化率。一般地,
hq(2+h)−q(2)=h2[(2+h)2−22]=h8h+2h2=8+2h,令非零 h 趋近 0,局部斜率趋近 8。
4-N02 答案
先写 P(y)=100u−2、u=1+y。幂函数求导给出 d(100u−2)/du=−200u−3,而 du/dy=1,因此
P′(y)=−200(1+y)−3.再求一次导数:
P′′(y)=(−200)(−3)(1+y)−4=600(1+y)−4.在 y=0.05 处,P′(0.05)≈−172.7675,P′′(0.05)≈493.6215。P′ 的单位是“价格单位/单位小数收益率”,P′′ 是“价格单位/小数收益率单位平方”。25bp =25×0.0001=0.0025,所以一阶价格变化为
ΔP≈P′(0.05)(0.0025)≈−0.4319个价格单位。负号表示在这条构造定价公式下,收益率上升带来局部价格下降;它本身不预报收益率方向。
4-N03 答案
代码先算了价格差,再除以收益率差,所以 reported_price_change 实际是差商,单位为“价格/单位小数收益率”,不是 1bp 的价格变化。断言检验的是该区间平均变化率与 P′(0.05)≈−172.7675 相差不到 0.1,变量名没有改变这个单位。下面先乘 h 得到线性近似,再直接相减得到精确构造值:
def price(y):
    return 100.0 / (1.0 + y) ** 2

y = 0.05
one_bp = 0.0001
slope = -200.0 / (1.0 + y) ** 3
linear_price_change = slope * one_bp
exact_price_change = price(y + one_bp) - price(y)
assert abs(linear_price_change - (-0.01727675197063)) < 1e-12
assert abs(exact_price_change - (-0.0172742842)) < 1e-10
线性近似约为 −0.0172767520,精确构造值约为 −0.0172742842 个价格单位。两者的细小差别来自曲率。
4-N04 答案
P′(0.05) 是本章单现金流、两年期、年复利定价公式在 5% 收益率处的局部斜率。给定收益率上升 1bp,公式的一阶价格变化约为 −0.0173 个价格单位;导数不包含明天的收益率变化方向,所以不能推出“收益率明天会上升”。它也不证明真实债券会实现同样的价格变化。
报告真实债券敏感度前,应记录证券身份、票息与现金流日期、剩余期限、日计数、收益率复利口径、净价或全价、报价来源和观察时间、收益率与价格的匹配方式及数据版本。若进一步声称未来价格变化,还要用时间上可用的数据检验收益率方向,并核对交易成本与持仓生效时间。
4-E01 答案
可微说明割线斜率在点附近收敛到有限值。把
f(x+h)−f(x)=h(hf(x+h)−f(x))两边令 h→0,差商有限且收敛,所以函数增量趋于 0,函数在该点连续。反例取 f(x)=∣x∣ 于 0:右差商是 1,左差商是 −1,导数不存在,但函数值与极限都是 0。
4-E02 答案
1bp =0.0001,25bp =0.0025,100bp =0.01。把 .01 标作 1bp,实际用了100bp,冲击放大100倍,绝对误差为99bp。
4-E03 答案
P′(y)=−200(1+y)−3.在 5% 处,P′(0.05)=−172.7675197063 个价格单位/单位小数收益率。负号表示该定价公式的价格随收益率上升而下降。它给定当前位置的局部斜率,不估计收益率明日涨跌方向。
4-E04 答案
∂x∂g=2x,∂z∂g=3.在 t=0,x=1,z=0,故偏导数分别为 2 和 3。链式法则给出 dg/dt=(∂g/∂x)x′(t)+(∂g/∂z)z′(t)=2(1)+3(2)=8。直接代入得 g(t)=(1+t)2+6t,求导为 2(1+t)+6,在 0 也是 8。
4-E05 答案
若方向向量长度不同,Duf=∇f⊤u 会同时受朝向和速度尺度影响。单位化后只比较方向。对 u=(1,1),∥u∥=2,单位方向为 (1/2,1/2)。
4-E06 答案
∇q=[2x+yx+4y],∇2q=[2114].首个主子式 2 大于 0,行列式 8−1=7>0,所以 Hessian 正定。该严格凸二次函数的驻点是严格局部且全局最小。解 ∇q=0 得 x=y=0。
4-E07 答案
沿 w+θh 的线段,函数需要三阶可微,才能写出以某个中间点三阶导数表示的 Lagrange 余项;若要给统一误差界,还需三阶导数有界。若 f 是二次多项式,二阶 Taylor 多项式与函数完全相同,三阶余项为零。
4-E08 答案
局部极小可取 f1=x2+y2,梯度在原点为 0,Hessian 2I 正定;局部极大可取 f2=−x2−y2,Hessian −2I 负定;鞍点可取 f3=x2−y2,Hessian diag(2,−2) 不定。
4-E09 答案
∫012xdx=[x2]01=1.若 g(x)=2x 是 F(x)=x2 的边际变化率,那么从 0 走到 1,累积的总变化是 F(1)−F(0)=1。
4-P01 参考实现
在项目冻结环境执行此片段。它从教学输入重新定义函数,并对解析与数值导数分别做断言:
import numpy as np
from quant_course.math_tools import finite_difference_gradient, finite_difference_hessian

face_value = 100.0
y = 0.05
price = lambda point: face_value / (1.0 + point[0]) ** 2
exact_first = -2.0 * face_value / (1.0 + y) ** 3
exact_second = 6.0 * face_value / (1.0 + y) ** 4
numeric_first = finite_difference_gradient(price, [y], step=1e-4)[0]
numeric_second = finite_difference_hessian(price, [y], step=1e-3)[0, 0]
one_bp = price(np.array([y + 0.0001])) - price(np.array([y]))
one_hundred_bp = price(np.array([y + 0.01])) - price(np.array([y]))

print("price:", price(np.array([y])))
print("first:", exact_first, numeric_first)
print("second:", exact_second, numeric_second)
print("1 bp exact price change:", one_bp)
print("100 bp exact price change:", one_hundred_bp)
assert np.isclose(exact_first, -172.7675197063)
assert np.isclose(exact_second, 493.6214848751)
assert np.isclose(numeric_first, exact_first, rtol=1e-6)
assert np.isclose(numeric_second, exact_second, rtol=2e-6)
assert np.isclose(one_bp, -0.0172742842, atol=1e-10)
assert np.isclose(one_hundred_bp, -1.7033038444, atol=1e-10)
4-P02 参考实现
下面的目标和权重均在片段中定义。中心差分仅负责核对;解析梯度给出更新方向:
import numpy as np
from quant_course.math_tools import finite_difference_gradient, finite_difference_hessian

sigma = np.array([[0.04, 0.01], [0.01, 0.09]])
mu = np.array([0.05, 0.08])
weights = np.array([0.6, 0.4])

def objective(point: np.ndarray) -> float:
    return float(0.5 * point @ sigma @ point - mu @ point)

gradient = sigma @ weights - mu
numeric_gradient = finite_difference_gradient(objective, weights)
hessian = finite_difference_hessian(objective, weights)
new_weights = weights - 0.1 * gradient
print("objective:", objective(weights))
print("gradient:", gradient)
print("numeric gradient:", numeric_gradient)
print("numeric Hessian:\\n", hessian)
print("new weights:", new_weights, "sum:", new_weights.sum())
print("new objective:", objective(new_weights))
assert np.isclose(objective(weights), -0.0452)
assert np.allclose(gradient, [-0.022, -0.038])
assert np.allclose(numeric_gradient, gradient, atol=1e-9)
assert np.allclose(hessian, sigma, atol=2e-7)
assert objective(new_weights) < objective(weights)
assert not np.isclose(new_weights.sum(), 1.0)
最后一个断言刻意显示更新破坏了满仓约束。程序优化目标下降,不等同于约束问题已经求解。
4-P03 参考实现
数值导数在非均匀网格上用真实坐标数组。中点求积对 x2 的近似会随区间变细而改善:
import numpy as np

nodes = np.array([0.0, 0.4, 1.0, 1.8, 3.0])
samples = nodes**2
derivative = np.gradient(samples, nodes)
print("interior derivative at x=1:", derivative[2])
assert np.isclose(derivative[2], 2.0)

def midpoint_integral(n: int) -> float:
    edges = np.linspace(0.0, 1.0, n + 1)
    midpoints = (edges[:-1] + edges[1:]) / 2.0
    width = 1.0 / n
    return float(np.sum(midpoints**2) * width)

exact = 1.0 / 3.0
errors = [abs(midpoint_integral(n) - exact) for n in (10, 100, 1000)]
print("midpoint errors:", errors)
assert errors[0] > errors[1] > errors[2]
中点规则对这个光滑函数的误差随步长缩小;解析真值由 [x3/3]01=1/3 得到。NumPy gradient 在非均匀网格上对内部样本使用相邻坐标间距构造差分。
4-C01 参考论证与数值
直接计算得到:
| 收益率变化 |
基点 |
精确价格变化 |
一阶近似 |
二阶近似 |
| 0.0001 |
1 bp |
-0.0172742842 |
-0.0172767520 |
-0.0172742839 |
| 0.0025 |
25 bp |
-0.4303811146 |
-0.4319187993 |
-0.4303762321 |
| 0.0100 |
100 bp |
-1.7033038444 |
-1.7276751971 |
-1.7029941228 |
接受阈值取决于用途。若定义绝对价格误差阈值为 0.001,这三个冲击的二阶近似都满足,100bp 的一阶近似则不满足。若阈值是相对精确变化的 0.1%,100bp 二阶误差约 0.0182%,仍满足;一阶误差约 1.43%,不满足。应把阈值在看结果前写下,并对步长附近的冲击做敏感性检查。
舍入误差(roundoff error)来自有限精度算术,常在步长极小时表现为误差平台;模型误差(model error)来自现金流、收益率口径或经济假设不适用。减小数值差分步长可以改变前者,不能修复后者。本题公式只代表构造债券,不能证明真实债券具有相同的报价误差。
4-C02 参考推导和候选最优解
无约束驻点满足 Σw−μ=0,即
w0=Σ−1μ≈[1.05714285710.7714285714].它的权重和约 1.82857,所以不满足满仓;它也不是带预算约束的解。
只加预算等式 1⊤w=1,构造拉格朗日函数(Lagrangian)
L(w,λ)=21w⊤Σw−μ⊤w+λ(1⊤w−1).一阶条件是 Σw−μ+λ1=0,所以
w(λ)=Σ−1(μ−λ1),λ=1⊤Σ−111⊤Σ−1μ−1.代入本章参数得到
λ≈0.0263636364,w=(0.45454545,0.54545455)⊤.目标值约为 −0.0463636364。两项权重非负,因而该点也满足长仓约束。由于该矩阵正定,严格凸目标的可行域是凸集,这个等式约束解同时是非负约束问题的唯一全局最优解。作为边界检查,w=(1,0) 时 f=−.03,w=(0,1) 时 f=−.035,二者都高于内部解的目标值。
可用代码核验等式解:
import numpy as np

sigma = np.array([[0.04, 0.01], [0.01, 0.09]])
mu = np.array([0.05, 0.08])
ones = np.ones(2)
sigma_inverse_mu = np.linalg.solve(sigma, mu)
sigma_inverse_ones = np.linalg.solve(sigma, ones)
lagrange_multiplier = (ones @ sigma_inverse_mu - 1.0) / (ones @ sigma_inverse_ones)
weights = np.linalg.solve(sigma, mu - lagrange_multiplier * ones)

def objective(point: np.ndarray) -> float:
    point = np.asarray(point, dtype=float)
    return float(0.5 * point @ sigma @ point - mu @ point)

kkt_residual = sigma @ weights - mu + lagrange_multiplier * ones
print("lambda:", lagrange_multiplier)
print("constrained weights:", weights)
print("KKT stationarity residual:", kkt_residual)
print("sum:", weights.sum(), "objective:", objective(weights))
print("boundary objectives:", objective([1.0, 0.0]), objective([0.0, 1.0]))
assert np.isclose(weights.sum(), 1.0)
assert np.allclose(kkt_residual, np.zeros(2), atol=1e-12)
assert np.isclose(objective(weights), -0.0463636364)
assert np.all(weights >= 0.0)
assert objective(weights) < min(objective([1.0, 0.0]), objective([0.0, 1.0]))
在更高维问题中,加入 w≥0 后需检查哪些资产权重落在边界、对应 Karush–Kuhn–Tucker(KKT)互补松弛条件是否满足,并核验求解器报告的可行性残差、目标值和对偶条件。求解器状态“成功”本身不是完整数值验收。
4-B01 答案
二次目标在增量 h 下的精确变化为 g⊤h+21h⊤Σh。代入 h=−ηg,得到 −.001928η+.00008302η2,所以严格下降要求 0<η<.001928/.00008302≈23.22331968。η=.1 时变化为 −.0001919698,权重为 (.6022,.4038),和为 1.006;η=30 时变化为 +.016878,权重为 (1.26,1.54),和为 2.8。两步都不满足满仓预算,后者还上升。
可行路径 w+sd=(.6−s,.4+s)⊤ 的和恒为1;两坐标非负且 s≥0 时要求 0≤s≤.6。沿此路径的精确变化为 −.016s+.055s2,因此 s=.01 得 −.0001545。可行区间内也并非任意步长都下降:正步严格下降还要求 s<.016/.055。这些是固定教学评分函数的条件;真实收益改善还依赖估计、当时信息、成交、费用与样本外评价。
19. Further Reading
- Must Know:MIT 18.01SC 第 3–5 节和第 48 节,用于复习导数作为变化率、极限与连续性、微积分基本定理。
- Must Know:MIT 18.02SC 第 26–30 节、第 32–38 节,覆盖偏导、切平面近似、优化、链式法则、全微分、梯度和方向导数。
- Should Know:NumPy gradient 文档,了解规则或非均匀采样间距、内部中心差分和边界差分的 API 语义。
- Advanced:Boyd 与 Vandenberghe《凸优化》第 3.1 节、第 9 章,阅读一阶/二阶最优条件与下降方法。用于把本章局部微积分连接到凸性和数值优化。
- Optional:MIT 18.01SC Taylor’s Formula 资源,用于进一步学习一元 Taylor 展开与余项。
20. References
本章来源、URL、核验方法和支持边界见 source_notes.md。数学定义由原创中文解释和逐步推导呈现;MIT OCW 支持课程主题与公式结构,Boyd 支持凸目标的一、二阶最优条件,NumPy 文档支持数组差分 API 行为。债券与二次目标数值是作者构造,外部来源不支持其作为市场事实。