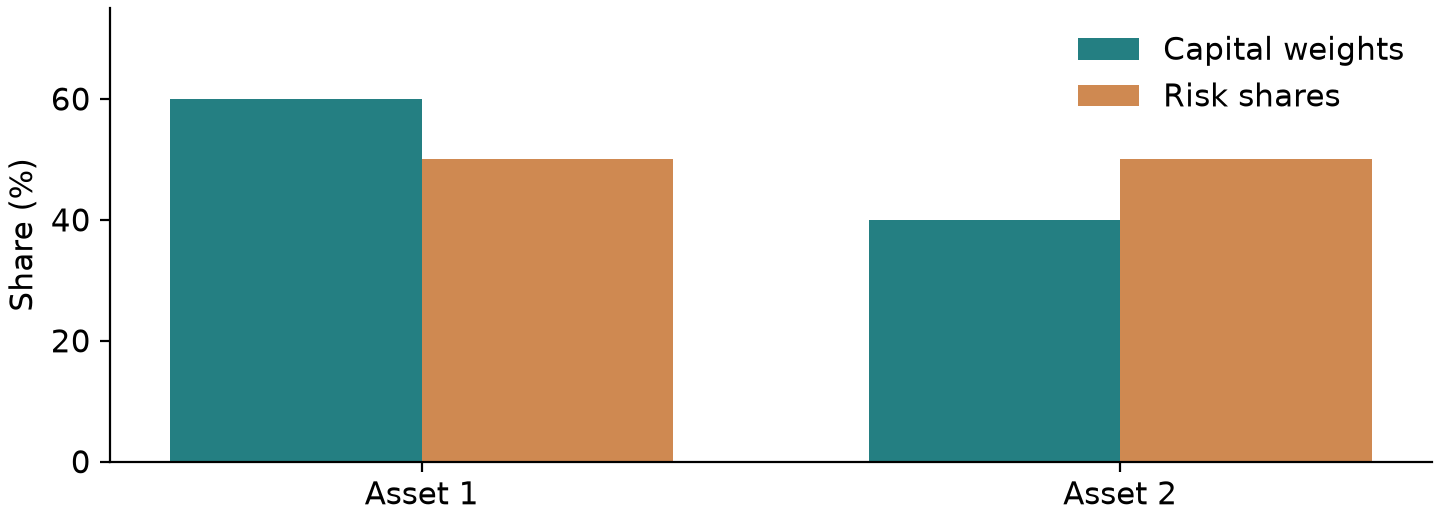第 21 章/ 45
实用组合构建(Practical Portfolio Construction)
先修:第 9 章凸二次规划与KKT条件、第 15 章多因子风险模型、第 18 章波动率估计、第 20 章现代组合理论与无约束均值方差切点解析式。
完成本章后,你能:用训练窗口 Ledoit–Wolf 收缩估计协方差,检查条件正定与样本外风险误差;将非凹的长仓最大 Sharpe 比率优化精确等价转化为凸二次规划(Convex QP);求解等风险贡献(Equal Risk Contribution, ERC)组合;使用 Black–Litterman 模型融合市场均衡与主观观点;推导 Kelly 准则对数增长率并说明折减约束;计算资产漂移与交易换手成本;在扣除成本后客观评测组合样本外表现。
1. 本章目标
完成本章学习后,你应能:
计算样本均值与协方差的估计误差,定量解释为什么期望收益的不确定性比协方差矩阵对优化权重具有更强的破坏性;
推导 Ledoit–Wolf(2004)向缩放单位阵收缩的最优强度,并用训练窗数据计算样本外正定协方差矩阵;
计算买卖双边再平衡换手率、持仓漂移权重及交易摩擦成本拖累,建立毛收益与扣费后净收益的核算台账;
区分美元中性、Beta 中性与行业中性,说明互斥且穷尽的绝对行业中性如何推出美元中性、为何一般不能推出Beta中性,并解释欧氏投影只优化权重距离;
推导组合波动率的 Euler 分解,计算边际风险贡献与相对风险份额,使用带有 Newton 减量停止准则的阻尼 Newton 法求解 ERC 权重;
复述第 9 章已证明的长仓最大 Sharpe 变量代换(化为凸二次规划),并实现带上限可行性预检的求解流程;
推导 Black–Litterman 模型的反向优化先验、分块高斯后验均值与后验均值协方差,验证观点正交倾斜性质;
推导 Kelly 准则的二元对数增长最优解与离散二阶展开与扩散极限二次代理,分析全额 Kelly 的尾部破产机制与半 Kelly 风险收益权衡;
结合多因子风险模型完成组合方差与波动率的因子/特异风险贡献分解;
基于 French 10 行业历史快照和 Project 3 的 440 个月滚动回测,客观评价各组合策略在当前修订历史快照上的成本后滚动样本外表现与统计不确定性,不将其视为PIT可交易证据。
本章完成条件:能独立复现所有数值算例并通过代码断言,理解全部模型的前提假设与失效边界,完成第 15 至 17 节的所有练习题,并在第 18 节核对完整推导与代码。
2. 为什么 Quant 需要实用组合构建
在第 20 章的均值方差理论(Modern Portfolio Theory, MPT)中,切点组合权重由解析式 w ∗ ∝ Σ − 1 μ e x c e s s \mathbf{w}^* \propto \Sigma^{-1}\boldsymbol{\mu}_{excess} w ∗ ∝ Σ − 1 μ e x cess μ ^ \hat{\boldsymbol{\mu}} μ ^ S S S
这一失败源于三个无法回避的实务挑战:
首先,参数估计误差被求逆过程急剧放大 。金融时间序列充斥着低信噪比噪声。期望收益的年化估计标准差通常与均值本身处于同一数量级,而高维协方差矩阵的最小特征值往往极度接近于零。当对带有噪声的矩阵求逆时,极小特征值对应的特征向量方向被急剧放大,使得优化器在样本内噪声最大的方向上建立巨大的多空杠杆。这一现象在量化界被称为“误差放大器(error maximizer)”。
其次,理论切点组合缺乏对现实交易摩擦与约束的建模 。理论解析式假设可以无限制卖空、无融资借贷利率惩罚、无流动性冲击和交易佣金。然而在实际机构投资中,投资经理受到严格的长仓限制(long-only)、单资产权重上限(position limits)、行业与市场风险暴露预算,以及由资金换手引发的滑点磨损。若忽略这些现实边界,账面上看似优异的策略收益将在每个月的再平衡成本中被侵蚀殆尽。
最后,分散化的定义在实践中存在重大混淆 。名义上的资产等权配置并不等同于风险上的分散。如果一个组合中包含高波动资产,其组合总风险的大部分将被少数资产主导。同样,声称“市场中性”的多空组合,若仅满足资金美元中性,依然可能承担巨大的系统性市场 Beta 暴露或行业倾斜风险。
实用组合构建的目标,正是运用数学上严谨的收缩估计(shrinkage estimation)、凸优化变换(convex QP transformation)、风险预算(risk budgeting)与贝叶斯先验约束,将充满噪声的预测信号转化为样本外可执行、风险可控且具备抗摩擦能力的真实持仓。
3. 直觉:从样本噪声到可执行持仓
为了理解无约束优化的脆弱性,我们先考察一个极简直觉实验:
设市场上有两个资产,真实月度超额收益均为 1.0 % 1.0\% 1.0% 4.0 % 4.0\% 4.0% 0.7 0.7 0.7 50 % 50\% 50% 1.3 % 1.3\% 1.3% 0.7 % 0.7\% 0.7% 0.3 % 0.3\% 0.3% 4.0 % / 60 ≈ 0.52 % 4.0\% / \sqrt{60} \approx 0.52\% 4.0%/ 60 ≈ 0.52% Σ − 1 μ e x c e s s \Sigma^{-1}\boldsymbol{\mu}_{excess} Σ − 1 μ e x cess Σ − 1 \Sigma^{-1} Σ − 1 [ 1 − 0.7 − 0.7 1 ] \begin{bmatrix}1&-0.7\\-0.7&1\end{bmatrix} [ 1 − 0.7 − 0.7 1 ] ( 1.3 − 0.7 × 0.7 , 0.7 − 0.7 × 1.3 ) = ( 0.81 , − 0.21 ) (1.3-0.7\times0.7,\ 0.7-0.7\times1.3)=(0.81,-0.21) ( 1.3 − 0.7 × 0.7 , 0.7 − 0.7 × 1.3 ) = ( 0.81 , − 0.21 ) ( 135 % , − 35 % ) (135\%,-35\%) ( 135% , − 35% ) ( 50 % , 50 % ) (50\%,50\%) ( 50% , 50% ) ( 135 % , − 35 % ) (135\%,-35\%) ( 135% , − 35% ) 4 % × 1.35 2 + 0.35 2 − 2 ( 0.7 ) ( 1.35 ) ( 0.35 ) = 4.53 % 4\%\times\sqrt{1.35^2+0.35^2-2(0.7)(1.35)(0.35)}=4.53\% 4% × 1.3 5 2 + 0.3 5 2 − 2 ( 0.7 ) ( 1.35 ) ( 0.35 ) = 4.53% 4 % × 0.85 = 3.69 % 4\%\times\sqrt{0.85}=3.69\% 4% × 0.85 = 3.69% ρ = 0.5 \rho=0.5 ρ = 0.5 ( 95 % , 5 % ) (95\%,5\%) ( 95% , 5% )
这个极简案例揭示了实用组合构建的核心逻辑:
收缩是控制协方差病态的护栏 :样本协方差在样本量有限时极端特征值过度发散。通过向结构化目标(如对角阵或因子模型)按理论最优比例“收缩”,可以压制微小特征值,避免逆矩阵将局部噪声放大为极端头寸。约束是防御均值估计灾难的第一道防线 :长仓约束(不允许卖空)在数学上截断了负权重的无限放大机制。虽然长仓约束使得解析式失效,但它把优化限制在概率单纯形(simplex)内,有效阻止了极端对冲头寸的形成。风险平价(Risk Parity)绕开了对不可靠期望收益的依赖 :当期望收益完全无法精准估计时,退而求其次,用协方差矩阵构建“所有资产对总风险贡献相等”的投资组合,可避开均值估计这一个误差来源;它仍依赖风险模型,收益与风险是否改善要在样本外比较。摩擦成本决定了最优换手边界 :每个月价格波动会导致资产市值比例自然偏离目标(此即漂移)。如果每个月都强行将组合微调回精确目标,换手带来的手续费和冲击成本将迅速积累。必须在偏离跟踪误差与换手摩擦之间寻求平衡。
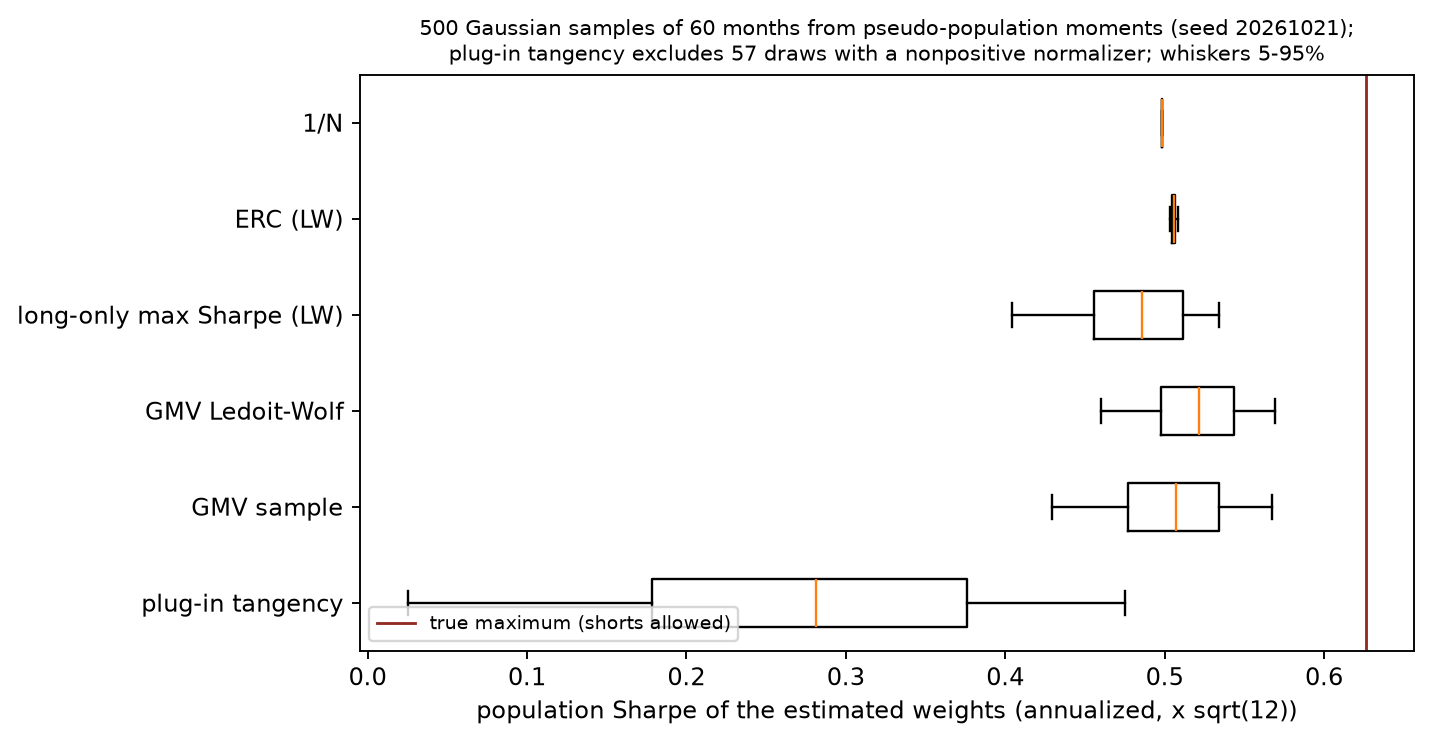
估计误差模拟与策略分布对比
横轴 :各策略估计权重代入真实总体后实现的年化总体 Sharpe 比率(已乘 12 \sqrt{12} 12 纵轴 :6 种对比策略(plug-in tangency、GMV sample、GMV Ledoit-Wolf、long-only max Sharpe (LW)、ERC (LW)、1/N);单位 :无量纲 Sharpe 比率;样本与环境 :将全样本 French 10 行业月度一阶矩与二阶矩作为固定“伪总体(pseudo-population)”,随机种子 20261021,进行 500 次独立高斯蒙特卡洛抽样,每次样本长度为 60 个月(代表 5 年滚动窗口);读法与观察点 :
理论最大真实切点 Sharpe 比率由红竖线标出(年化约 0.6262 0.6262 0.6262
无约束插件切点组合(plug-in tangency)表现最差,其年化 Sharpe 中位数仅 0.2812 0.2812 0.2812 0.079 0.079 0.079
引入长仓约束的 long-only max Sharpe(LW)中位数提升至 0.4859 0.4859 0.4859
完全不依赖期望收益估计的策略(GMV LW、ERC LW、1/N)表现最为稳健,其中 GMV (LW) 的年化 Sharpe 中位数达 0.5215 0.5215 0.5215 0.5057 0.5057 0.5057 0.4983 0.4983 0.4983
局限性 :本图展示的是纯粹的抽样误差统计模拟,所有资产回报严格服从高斯分布,未引入真实市场的跳跃、肥尾与结构突变。
4. 数学基础与符号约定
在深入推导前,统一全章的符号系统、矩阵维度与度量单位:
资产数量与样本期数 :资产数量记为 n n n p p p T T T
收益率向量 :t t t r t = ( r 1 , t , … , r n , t ) ⊤ ∈ R n \mathbf{r}_t = (r_{1,t}, \dots, r_{n,t})^\top \in \mathbb{R}^n r t = ( r 1 , t , … , r n , t ) ⊤ ∈ R n 1 % 1\% 1% 0.01 0.01 0.01
期望超额收益向量 :μ e x c e s s = μ − r f 1 ∈ R n \boldsymbol{\mu}_{excess} = \boldsymbol{\mu} - r_f \mathbf{1} \in \mathbb{R}^n μ e x cess = μ − r f 1 ∈ R n μ = E [ r ] \boldsymbol{\mu} = E[\mathbf{r}] μ = E [ r ] r f r_f r f 1 = ( 1 , … , 1 ) ⊤ \mathbf{1} = (1, \dots, 1)^\top 1 = ( 1 , … , 1 ) ⊤
协方差矩阵 :Σ ∈ R n × n \Sigma \in \mathbb{R}^{n \times n} Σ ∈ R n × n Σ ≻ 0 \Sigma \succ 0 Σ ≻ 0
持仓权重向量 :w = ( w 1 , … , w n ) ⊤ ∈ R n \mathbf{w} = (w_1, \dots, w_n)^\top \in \mathbb{R}^n w = ( w 1 , … , w n ) ⊤ ∈ R n w i w_i w i i i i 1 ⊤ w = 1 \mathbf{1}^\top \mathbf{w} = 1 1 ⊤ w = 1 w ≥ 0 \mathbf{w} \ge \mathbf{0} w ≥ 0
矩阵 Frobenius 范数约定 :本章遵循 Ledoit & Wolf(2004)文献规范,对 p × p p \times p p × p A A A p p p
∥ A ∥ 2 = 1 p tr ( A A ⊤ ) = 1 p ∑ i = 1 p ∑ j = 1 p a i j 2 ,
\|A\|^2 = \frac{1}{p}\operatorname{tr}(AA^\top) = \frac{1}{p}\sum_{i=1}^p \sum_{j=1}^p a_{ij}^2,
∥ A ∥ 2 = p 1 tr ( A A ⊤ ) = p 1 i = 1 ∑ p j = 1 ∑ p a ij 2 , 矩阵内积定义为 ⟨ A , B ⟩ = 1 p tr ( A B ⊤ ) \langle A, B \rangle = \frac{1}{p}\operatorname{tr}(AB^\top) ⟨ A , B ⟩ = p 1 tr ( A B ⊤ ) ∥ ⋅ ∥ \|\cdot\| ∥ ⋅ ∥
时间与信息集时点 :严守因果性。理想化月边界测试中,若在 t − 1 t-1 t − 1 [ t − W , t − 1 ] [t-W, t-1] [ t − W , t − 1 ] [ t − W − 1 , t − 2 ] [t-W-1, t-2] [ t − W − 1 , t − 2 ] t t t r t \mathbf{r}_t r t
5. 正式定义:估计误差、中性约束与风险预算
5.1 均值估计误差与协方差病态性
设资产收益率服从独立同分布,真实均值为 μ \boldsymbol{\mu} μ Σ \Sigma Σ μ ^ = 1 T ∑ t = 1 T r t \hat{\boldsymbol{\mu}} = \frac{1}{T}\sum_{t=1}^T \mathbf{r}_t μ ^ = T 1 ∑ t = 1 T r t
SE ( μ ^ i ) = σ i T .
\operatorname{SE}(\hat{\mu}_i) = \frac{\sigma_i}{\sqrt{T}}.
SE ( μ ^ i ) = T σ i . 若某资产月度波动率为 σ = 4 % \sigma = 4\% σ = 4% 13.86 % 13.86\% 13.86% T = 120 T = 120 T = 120
SE ( μ ^ i ) = 0.04 120 ≈ 0.003651 ( 0.365 % / 月 , 年化约 4.38 % ) .
\operatorname{SE}(\hat{\mu}_i) = \frac{0.04}{\sqrt{120}} \approx 0.003651 \quad (0.365\% / \text{月}, \text{年化约 } 4.38\%).
SE ( μ ^ i ) = 120 0.04 ≈ 0.003651 ( 0.365%/ 月 , 年化约 4.38% ) . 对一个假想股票,若研究者假设年化超额收益仅为 5 % ∼ 8 % 5\% \sim 8\% 5% ∼ 8%
样本协方差矩阵(去均值,除数为 T T T
S = 1 T ∑ t = 1 T ( r t − μ ^ ) ( r t − μ ^ ) ⊤ .
S = \frac{1}{T}\sum_{t=1}^T (\mathbf{r}_t - \hat{\boldsymbol{\mu}})(\mathbf{r}_t - \hat{\boldsymbol{\mu}})^\top.
S = T 1 t = 1 ∑ T ( r t − μ ^ ) ( r t − μ ^ ) ⊤ . Ledoit 与 Wolf(2004)§2.2 式(12)把 Lemma 2.1 改写为特征值形式:样本特征值围绕其共同均值的离散度,在期望上等于真实特征值的离散度加上 E ∥ S − Σ ∥ 2 E\lVert S-\Sigma\rVert^2 E ∥ S − Σ ∥ 2 p / T p/T p / T p > T p > T p > T S S S p − T + 1 p-T+1 p − T + 1 T − 1 T-1 T − 1 S − 1 S^{-1} S − 1 Σ \Sigma Σ
5.2 三种投资组合中性定义
量化投资中常追求消除特定宏观或系统性风险暴露,常见的“中性(neutrality)”概念包括:
美元中性(Dollar Neutrality / Capital Neutrality) :
1 ⊤ w = ∑ i = 1 n w i = 0.
\mathbf{1}^\top \mathbf{w} = \sum_{i=1}^n w_i = 0.
1 ⊤ w = i = 1 ∑ n w i = 0. 多头市值总和与空头市值总和完全相等,净资金暴露(Net Exposure)为 0。
Beta 中性(Beta Neutrality) :β = ( β 1 , … , β n ) ⊤ ∈ R n \boldsymbol{\beta} = (\beta_1, \dots, \beta_n)^\top \in \mathbb{R}^n β = ( β 1 , … , β n ) ⊤ ∈ R n
β ⊤ w = ∑ i = 1 n w i β i = 0.
\boldsymbol{\beta}^\top \mathbf{w} = \sum_{i=1}^n w_i \beta_i = 0.
β ⊤ w = i = 1 ∑ n w i β i = 0. 组合在边际上不受市场整体基准收益波动的直接线性冲击。
行业中性(Sector Neutrality) :K K K I k I_k I k k k k
∑ i ∈ I k w i = 0 , ∀ k ∈ { 1 , … , K } .
\sum_{i \in I_k} w_i = 0, \quad \forall k \in \{1, \dots, K\}.
i ∈ I k ∑ w i = 0 , ∀ k ∈ { 1 , … , K } .
这三种条件不同,但不彼此独立。若互斥行业集合覆盖全部资产,则逐行业求和给出
1 ⊤ w = ∑ k = 1 K ∑ i ∈ I k w i = 0.
\mathbf1^\top\mathbf w=\sum_{k=1}^K\sum_{i\in I_k}w_i=0.
1 ⊤ w = k = 1 ∑ K i ∈ I k ∑ w i = 0. 因此,本章的绝对行业中性必然推出美元中性,却一般不保证 Beta 中性;美元中性一般不保证行业或 Beta 中性,Beta 中性一般也不保证另两者。例如同一行业内权重 ( 0.5 , − 0.5 ) (0.5,-0.5) ( 0.5 , − 0.5 ) ( 1.5 , 0.5 ) (1.5,0.5) ( 1.5 , 0.5 ) 0.5 0.5 0.5 ( 0.5 , − 1.0 ) (0.5,-1.0) ( 0.5 , − 1.0 ) ( 1 , 0.5 ) (1,0.5) ( 1 , 0.5 ) − 0.5 -0.5 − 0.5 w b \mathbf w_b w b Z ( w − w b ) = 0 Z(\mathbf w-\mathbf w_b)=0 Z ( w − w b ) = 0 ∑ i w i = ∑ i w b , i \sum_iw_i=\sum_iw_{b,i} ∑ i w i = ∑ i w b , i Z Z Z K × n K\times n K × n
5.3 风险贡献与 Euler 分解
投资组合的总波动率函数为 σ ( w ) = w ⊤ Σ w \sigma(\mathbf{w}) = \sqrt{\mathbf{w}^\top \Sigma \mathbf{w}} σ ( w ) = w ⊤ Σ w a > 0 a > 0 a > 0 σ ( a w ) = a σ ( w ) \sigma(a\mathbf{w}) = a\sigma(\mathbf{w}) σ ( a w ) = aσ ( w ) w \mathbf{w} w 一阶齐次函数(homogeneous of degree 1) 。
以下求导和风险份额要求 σ ( w ) > 0 \sigma(\mathbf w)>0 σ ( w ) > 0 Σ \Sigma Σ
σ ( w ) = ∑ i = 1 n w i ∂ σ ( w ) ∂ w i .
\sigma(\mathbf{w}) = \sum_{i=1}^n w_i \frac{\partial \sigma(\mathbf{w})}{\partial w_i}.
σ ( w ) = i = 1 ∑ n w i ∂ w i ∂ σ ( w ) . 由此引出风险贡献体系的三项核心定义:
边际风险贡献(Marginal Risk Contribution, MRC) :
MRC i = ∂ σ ( w ) ∂ w i = ( Σ w ) i w ⊤ Σ w = ( Σ w ) i σ ( w ) .
\operatorname{MRC}_i = \frac{\partial \sigma(\mathbf{w})}{\partial w_i} = \frac{(\Sigma \mathbf{w})_i}{\sqrt{\mathbf{w}^\top \Sigma \mathbf{w}}} = \frac{(\Sigma \mathbf{w})_i}{\sigma(\mathbf{w})}.
MRC i = ∂ w i ∂ σ ( w ) = w ⊤ Σ w ( Σ w ) i = σ ( w ) ( Σ w ) i . MRC i \operatorname{MRC}_i MRC i i i i
绝对风险贡献(Risk Contribution, RC) :
RC i = w i MRC i = w i ( Σ w ) i σ ( w ) .
\operatorname{RC}_i = w_i \operatorname{MRC}_i = \frac{w_i (\Sigma \mathbf{w})_i}{\sigma(\mathbf{w})}.
RC i = w i MRC i = σ ( w ) w i ( Σ w ) i . 由 Euler 定理,所有资产的绝对风险贡献之和严格等于组合总波动率:∑ i = 1 n RC i = σ ( w ) \sum_{i=1}^n \operatorname{RC}_i = \sigma(\mathbf{w}) ∑ i = 1 n RC i = σ ( w )
相对风险份额(Risk Fraction / Relative Risk Contribution) :
p i = RC i σ ( w ) = w i ( Σ w ) i w ⊤ Σ w .
p_i = \frac{\operatorname{RC}_i}{\sigma(\mathbf{w})} = \frac{w_i (\Sigma \mathbf{w})_i}{\mathbf{w}^\top \Sigma \mathbf{w}}.
p i = σ ( w ) RC i = w ⊤ Σ w w i ( Σ w ) i . 相对风险份额无量纲,且满足加总条件:∑ i = 1 n p i = 1 \sum_{i=1}^n p_i = 1 ∑ i = 1 n p i = 1 p i p_i p i
5.4 等风险贡献组合(Equal Risk Contribution, ERC)
等风险贡献组合(ERC)要求在长仓全额投资单纯形上,所有资产对组合总波动率的绝对贡献完全均等:
RC i = RC j ⟺ w i ( Σ w ) i = w j ( Σ w ) j , ∀ i , j ∈ { 1 , … , n } ,
\operatorname{RC}_i = \operatorname{RC}_j \iff w_i (\Sigma \mathbf{w})_i = w_j (\Sigma \mathbf{w})_j, \quad \forall i, j \in \{1, \dots, n\},
RC i = RC j ⟺ w i ( Σ w ) i = w j ( Σ w ) j , ∀ i , j ∈ { 1 , … , n } , 即每个资产承担恰好 1 / n 1/n 1/ n p i = 1 / n p_i = 1/n p i = 1/ n
先核对两资产,而非直接背ERC公式。 年化小数教学构造:σ 1 = 0.2 , σ 2 = 0.3 , ρ = 0.2 \sigma_1=0.2,\sigma_2=0.3,\rho=0.2 σ 1 = 0.2 , σ 2 = 0.3 , ρ = 0.2
Σ = ( 0.04 0.012 0.012 0.09 ) .
\Sigma=\begin{pmatrix}0.04&0.012\\0.012&0.09\end{pmatrix}.
Σ = ( 0.04 0.012 0.012 0.09 ) . 令两项风险贡献相等,先乘掉同一正分母 σ p \sigma_p σ p
w 1 2 ( 0.04 ) + w 1 w 2 ( 0.012 ) = w 1 w 2 ( 0.012 ) + w 2 2 ( 0.09 ) , 0.04 w 1 2 = 0.09 w 2 2 , 0.2 w 1 = 0.3 w 2 (权重为正,才能取正平方根) .
\begin{aligned}
w_1^2(0.04)+w_1w_2(0.012)&=w_1w_2(0.012)+w_2^2(0.09),\\
0.04w_1^2&=0.09w_2^2,\\
0.2w_1&=0.3w_2\quad\text{(权重为正,才能取正平方根)}.
\end{aligned}
w 1 2 ( 0.04 ) + w 1 w 2 ( 0.012 ) 0.04 w 1 2 0.2 w 1 = w 1 w 2 ( 0.012 ) + w 2 2 ( 0.09 ) , = 0.09 w 2 2 , = 0.3 w 2 (权重为正,才能取正平方根) . 结合 w 1 + w 2 = 1 w_1+w_2=1 w 1 + w 2 = 1 ( w 1 , w 2 ) = ( 0.6 , 0.4 ) (w_1,w_2)=(0.6,0.4) ( w 1 , w 2 ) = ( 0.6 , 0.4 )
Σ w = ( 0.0288 , 0.0432 ) ⊤ , σ p 2 = 0.6 ( 0.0288 ) + 0.4 ( 0.0432 ) = 0.03456 , RC 1 = RC 2 = 0.01728 / 0.03456 = 0.092952.
\begin{aligned}
\Sigma\mathbf w&=(0.0288,0.0432)^\top,\\
\sigma_p^2&=0.6(0.0288)+0.4(0.0432)=0.03456,\\
\operatorname{RC}_1&=\operatorname{RC}_2=0.01728/\sqrt{0.03456}=0.092952.
\end{aligned}
Σ w σ p 2 RC 1 = ( 0.0288 , 0.0432 ) ⊤ , = 0.6 ( 0.0288 ) + 0.4 ( 0.0432 ) = 0.03456 , = RC 2 = 0.01728/ 0.03456 = 0.092952. 波动为18.59%,两项风险份额各50%,但资金份额是60%和40%。两资产交叉项相消,因此正波动、ρ ∈ ( − 1 , 1 ) \rho\in(-1,1) ρ ∈ ( − 1 , 1 )
横轴为两项资产,纵轴为份额(%);资金柱为60%/40%,风险柱为50%/50%。这张图只核对上述年化构造,不表示ERC收益较高。第6.3节将说明怎样在一般协方差矩阵下求指定风险预算。
6. 核心推导:收缩、凸QP变换与风险分解
6.1 Ledoit–Wolf 线性收缩估计量推导
Ledoit & Wolf(2004)寻求线性组合 Σ ∗ = ρ 1 I + ρ 2 S \Sigma^* = \rho_1 I + \rho_2 S Σ ∗ = ρ 1 I + ρ 2 S μ I \mu I μ I μ = ⟨ Σ , I ⟩ = 1 p tr ( Σ ) \mu = \langle \Sigma, I \rangle = \frac{1}{p}\operatorname{tr}(\Sigma) μ = ⟨ Σ , I ⟩ = p 1 tr ( Σ ) m = ⟨ S , I ⟩ m = \langle S, I \rangle m = ⟨ S , I ⟩ μ \mu μ Σ \Sigma Σ
min ρ 1 , ρ 2 E [ ∥ Σ ∗ − Σ ∥ 2 ] = E [ ∥ ρ 1 I + ρ 2 S − Σ ∥ 2 ] .
\min_{\rho_1, \rho_2} E\left[ \|\Sigma^* - \Sigma\|^2 \right] = E\left[ \|\rho_1 I + \rho_2 S - \Sigma\|^2 \right].
ρ 1 , ρ 2 min E [ ∥ Σ ∗ − Σ ∥ 2 ] = E [ ∥ ρ 1 I + ρ 2 S − Σ ∥ 2 ] . 根据正交分解与期望展开:
定义三个关键几何距离参数;本小节的δ 2 \delta^2 δ 2 δ \delta δ
样本协方差与目标的期望距离平方:δ 2 = E [ ∥ S − μ I ∥ 2 ] \delta^2 = E\left[ \|S - \mu I\|^2 \right] δ 2 = E [ ∥ S − μ I ∥ 2 ]
真实协方差与目标的距离平方:α 2 = ∥ Σ − μ I ∥ 2 \alpha^2 = \|\Sigma - \mu I\|^2 α 2 = ∥Σ − μ I ∥ 2
样本协方差对真实协方差的估计误差期望:β 2 = E [ ∥ S − Σ ∥ 2 ] \beta^2 = E\left[ \|S - \Sigma\|^2 \right] β 2 = E [ ∥ S − Σ ∥ 2 ]
先在理论基准 E [ S ] = Σ E[S]=\Sigma E [ S ] = Σ T T T E [ S ] = ( T − 1 ) Σ / T E[S]=(T-1)\Sigma/T E [ S ] = ( T − 1 ) Σ/ T
δ 2 = α 2 + β 2 .
\delta^2 = \alpha^2 + \beta^2.
δ 2 = α 2 + β 2 . Lemma 2.1 的证明只用到 E [ S ] = Σ E[S]=\Sigma E [ S ] = Σ E ∥ S − Σ + Σ − μ I ∥ 2 E\lVert S-\Sigma+\Sigma-\mu I\rVert^2 E ∥ S − Σ + Σ − μ I ∥ 2 2 ⟨ E [ S − Σ ] , Σ − μ I ⟩ = 0 2\langle E[S-\Sigma],\,\Sigma-\mu I\rangle=0 2 ⟨ E [ S − Σ ] , Σ − μ I ⟩ = 0 Σ ∗ \Sigma^* Σ ∗ Σ ∗ = κ ( μ I ) + ( 1 − κ ) S \Sigma^* = \kappa (\mu I) + (1 - \kappa) S Σ ∗ = κ ( μ I ) + ( 1 − κ ) S μ \mu μ
∥ Σ ∗ − Σ ∥ 2 = ∥ ( 1 − κ ) ( S − Σ ) − κ ( Σ − μ I ) ∥ 2 .
\|\Sigma^* - \Sigma\|^2 = \|(1 - \kappa)(S - \Sigma) - \kappa(\Sigma - \mu I)\|^2.
∥ Σ ∗ − Σ ∥ 2 = ∥ ( 1 − κ ) ( S − Σ ) − κ ( Σ − μ I ) ∥ 2 . 对期望展开并利用交叉项在一阶矩下的无偏正交性,得到关于收缩强度 κ \kappa κ
E [ ∥ Σ ∗ − Σ ∥ 2 ] = ( 1 − κ ) 2 β 2 + κ 2 α 2 .
E\left[ \|\Sigma^* - \Sigma\|^2 \right] = (1 - \kappa)^2 \beta^2 + \kappa^2 \alpha^2.
E [ ∥ Σ ∗ − Σ ∥ 2 ] = ( 1 − κ ) 2 β 2 + κ 2 α 2 . 对 κ \kappa κ
− 2 ( 1 − κ ) β 2 + 2 κ α 2 = 0 ⟹ κ ∗ = β 2 α 2 + β 2 = β 2 δ 2 .
-2(1 - \kappa)\beta^2 + 2\kappa\alpha^2 = 0 \implies \kappa^* = \frac{\beta^2}{\alpha^2 + \beta^2} = \frac{\beta^2}{\delta^2}.
− 2 ( 1 − κ ) β 2 + 2 κ α 2 = 0 ⟹ κ ∗ = α 2 + β 2 β 2 = δ 2 β 2 . 因此,理论最优收缩强度恰好等于估计误差方差占总离散度的比例 β 2 / δ 2 \beta^2/\delta^2 β 2 / δ 2 Σ \Sigma Σ
目标缩放尺度估计:m = 1 p tr ( S ) m = \frac{1}{p}\operatorname{tr}(S) m = p 1 tr ( S )
样本总偏离度估计:d 2 = ∥ S − m I ∥ 2 = 1 p ∑ i = 1 p ∑ j = 1 p ( s i j − m δ i j ) 2 d^2 = \|S - mI\|^2 = \frac{1}{p}\sum_{i=1}^p \sum_{j=1}^p (s_{ij} - m\delta_{ij})^2 d 2 = ∥ S − m I ∥ 2 = p 1 ∑ i = 1 p ∑ j = 1 p ( s ij − m δ ij ) 2
估计误差渐近无偏估计量:
设去均值样本矩阵各行为 x t ∈ R p \mathbf{x}_t \in \mathbb{R}^p x t ∈ R p x t x t ⊤ \mathbf{x}_t \mathbf{x}_t^\top x t x t ⊤ S S S T T T 1 / T 1/T 1/ T b ˉ 2 = 1 T 2 ∑ t ∥ x t x t ⊤ − S ∥ 2 \bar b^2=\frac{1}{T^2}\sum_t\lVert\mathbf{x}_t\mathbf{x}_t^\top-S\rVert^2 b ˉ 2 = T 2 1 ∑ t ∥ x t x t ⊤ − S ∥ 2 β 2 \beta^2 β 2 ∑ t x t ⊤ S x t = T ∥ S ∥ F 2 \sum_t\mathbf{x}_t^\top S\mathbf{x}_t=T\lVert S\rVert_F^2 ∑ t x t ⊤ S x t = T ∥ S ∥ F 2
b ˉ 2 = 1 T 2 p ( ∑ t = 1 T ∥ x t ∥ 2 4 − T ∑ i = 1 p ∑ j = 1 p s i j 2 ) ;
\bar{b}^2 = \frac{1}{T^2 p}\left( \sum_{t=1}^T \|\mathbf{x}_t\|_2^4 - T \sum_{i=1}^p \sum_{j=1}^p s_{ij}^2 \right);
b ˉ 2 = T 2 p 1 ( t = 1 ∑ T ∥ x t ∥ 2 4 − T i = 1 ∑ p j = 1 ∑ p s ij 2 ) ;
截断收缩强度:b 2 = min ( max ( b ˉ 2 , 0 ) , d 2 ) b^2 = \min(\max(\bar{b}^2, 0), d^2) b 2 = min ( max ( b ˉ 2 , 0 ) , d 2 )
κ ^ = b 2 d 2 ∈ [ 0 , 1 ] .
\hat{\kappa} = \frac{b^2}{d^2} \in [0, 1].
κ ^ = d 2 b 2 ∈ [ 0 , 1 ] .
最终可得半正定的可行收缩估计量,严格正定需要下述条件:
S ∗ = κ ^ ( m I ) + ( 1 − κ ^ ) S .
S^* = \hat{\kappa} (mI) + (1 - \hat{\kappa}) S.
S ∗ = κ ^ ( m I ) + ( 1 − κ ^ ) S . 由于目标阵 m I mI m I κ ^ > 0 \hat{\kappa} > 0 κ ^ > 0 T < p T < p T < p S S S S ∗ S^* S ∗
6.2 长仓最大 Sharpe 比率的凸二次规划等价变换
最大化投资组合 Sharpe 比率的原始长仓优化问题为:
max w μ e x c e s s ⊤ w w ⊤ Σ w s.t. 1 ⊤ w = 1 , w ≥ 0 , w ≤ w max .
\max_{\mathbf{w}} \frac{\boldsymbol{\mu}_{excess}^\top \mathbf{w}}{\sqrt{\mathbf{w}^\top \Sigma \mathbf{w}}} \quad \text{s.t.} \quad \mathbf{1}^\top \mathbf{w} = 1, \quad \mathbf{w} \ge \mathbf{0}, \quad \mathbf{w} \le \mathbf{w}_{\max}.
w max w ⊤ Σ w μ e x cess ⊤ w s.t. 1 ⊤ w = 1 , w ≥ 0 , w ≤ w m a x . 目标是比值,不是凹函数,不能按凸优化建模规则(Disciplined Convex Programming, DCP)直接交给 CVXPY。第 9 章第 7 节与 9-C01 已经证明下面的变量代换及其条件;这里按本章实现复述一遍,Lesniewski(Baruch MFE 讲义 Lecture 5)给出同一变换。
证明过程 :
以下讨论有限Sharpe,要求正超额收益可行组合均具有正方差;Σ ≻ 0 \Sigma\succ0 Σ ≻ 0
先区分三个门槛。预算可行要求 n w max ≥ 1 nw_{\max}\ge1 n w m a x ≥ 1 max w μ e x c e s s ⊤ w > 0 \max_w\mu_{excess}^\top w>0 max w μ e x cess ⊤ w > 0 Σ ≻ 0 \Sigma\succ0 Σ ≻ 0 w w w w ⊤ Σ w = 0 w^\top\Sigma w=0 w ⊤ Σ w = 0 μ e x c e s s ⊤ w > 0 \mu_{excess}^\top w>0 μ e x cess ⊤ w > 0
假设可行域内至少存在一个组合具有严格正的期望超额收益,即 max w μ e x c e s s ⊤ w > 0 \max_{\mathbf{w}} \boldsymbol{\mu}_{excess}^\top \mathbf{w} > 0 max w μ e x cess ⊤ w > 0
κ = 1 μ e x c e s s ⊤ w > 0 ,
\kappa = \frac{1}{\boldsymbol{\mu}_{excess}^\top \mathbf{w}} > 0,
κ = μ e x cess ⊤ w 1 > 0 , 并定义缩放权重向量:
y = κ w ∈ R n .
\mathbf{y} = \kappa \mathbf{w} \in \mathbb{R}^n.
y = κ w ∈ R n . 由于 w ≥ 0 \mathbf{w} \ge \mathbf{0} w ≥ 0 κ > 0 \kappa > 0 κ > 0 y ≥ 0 \mathbf{y} \ge \mathbf{0} y ≥ 0
期望超额收益归一化:
μ e x c e s s ⊤ y = κ ( μ e x c e s s ⊤ w ) = 1 ;
\boldsymbol{\mu}_{excess}^\top \mathbf{y} = \kappa (\boldsymbol{\mu}_{excess}^\top \mathbf{w}) = 1;
μ e x cess ⊤ y = κ ( μ e x cess ⊤ w ) = 1 ;
投资比例约束:
1 ⊤ y = κ ( 1 ⊤ w ) = κ ;
\mathbf{1}^\top \mathbf{y} = \kappa (\mathbf{1}^\top \mathbf{w}) = \kappa;
1 ⊤ y = κ ( 1 ⊤ w ) = κ ;
上限约束:
w i ≤ w max ⟺ y i ≤ w max κ .
w_i \le w_{\max} \iff y_i \le w_{\max} \kappa.
w i ≤ w m a x ⟺ y i ≤ w m a x κ .
考察目标函数的倒数平方:
1 SR ( w ) 2 = w ⊤ Σ w ( μ e x c e s s ⊤ w ) 2 = ( κ w ) ⊤ Σ ( κ w ) (同一正比例缩放) = y ⊤ Σ y (代入定义) .
\begin{aligned}
\frac{1}{\operatorname{SR}(\mathbf w)^2}
&=\frac{\mathbf w^\top\Sigma\mathbf w}{(\boldsymbol\mu_{excess}^\top\mathbf w)^2}\\
&=(\kappa\mathbf w)^\top\Sigma(\kappa\mathbf w)\quad\text{(同一正比例缩放)}\\
&=\mathbf y^\top\Sigma\mathbf y\quad\text{(代入定义)}.
\end{aligned}
SR ( w ) 2 1 = ( μ e x cess ⊤ w ) 2 w ⊤ Σ w = ( κ w ) ⊤ Σ ( κ w ) (同一正比例缩放) = y ⊤ Σ y (代入定义) . 因此,最大化 Sharpe 比率等价于最小化其平方倒数:
min y ∈ R n , κ ∈ R y ⊤ Σ y
\min_{\mathbf{y} \in \mathbb{R}^n, \kappa \in \mathbb{R}} \mathbf{y}^\top \Sigma \mathbf{y}
y ∈ R n , κ ∈ R min y ⊤ Σ y 受制于线性约束:
{ μ e x c e s s ⊤ y = 1 , 1 ⊤ y = κ , y ≥ 0 , y ≤ w max κ , κ > 0.
\begin{cases}
\boldsymbol{\mu}_{excess}^\top \mathbf{y} = 1, \\
\mathbf{1}^\top \mathbf{y} = \kappa, \\
\mathbf{y} \ge \mathbf{0}, \\
\mathbf{y} \le w_{\max} \kappa, \\
\kappa > 0.
\end{cases}
⎩ ⎨ ⎧ μ e x cess ⊤ y = 1 , 1 ⊤ y = κ , y ≥ 0 , y ≤ w m a x κ , κ > 0. Σ ⪰ 0 \Sigma \succeq 0 Σ ⪰ 0 y ⊤ Σ y \mathbf{y}^\top \Sigma \mathbf{y} y ⊤ Σ y Σ ≻ 0 \Sigma\succ0 Σ ≻ 0 κ > 0 \kappa>0 κ > 0 μ e x c e s s ⊤ y = 1 \boldsymbol{\mu}_{excess}^\top\mathbf{y}=1 μ e x cess ⊤ y = 1 y ≠ 0 \mathbf{y}\ne\mathbf{0} y = 0 y ≥ 0 \mathbf{y}\ge\mathbf{0} y ≥ 0 κ = 1 ⊤ y > 0 \kappa=\mathbf{1}^\top\mathbf{y}>0 κ = 1 ⊤ y > 0 w = y / κ \mathbf{w}=\mathbf{y}/\kappa w = y / κ ( y , κ ) (\mathbf{y},\kappa) ( y , κ ) 1 / SR 2 1/\operatorname{SR}^2 1/ SR 2 ( y ∗ , κ ∗ ) (\mathbf{y}^*, \kappa^*) ( y ∗ , κ ∗ )
w ∗ = y ∗ κ ∗ = y ∗ ∑ i = 1 n y i ∗ .
\mathbf{w}^* = \frac{\mathbf{y}^*}{\kappa^*} = \frac{\mathbf{y}^*}{\sum_{i=1}^n y_i^*}.
w ∗ = κ ∗ y ∗ = ∑ i = 1 n y i ∗ y ∗ . 证毕。
6.3 风险预算(ERC)的凸对数障碍规划与阻尼 Newton 算法
Maillard、Roncalli 与 Teiletche(2009)§3.4 把 ERC 写成带约束 ∑ i ln x i ≥ c \sum_i\ln x_i\ge c ∑ i ln x i ≥ c
min y ∈ R n , y > 0 f ( y ) = 1 2 y ⊤ Σ y − ∑ i = 1 n b i ln y i ,
\min_{\mathbf{y} \in \mathbb{R}^n, \mathbf{y} > \mathbf{0}} f(\mathbf{y}) = \frac{1}{2}\mathbf{y}^\top \Sigma \mathbf{y} - \sum_{i=1}^n b_i \ln y_i,
y ∈ R n , y > 0 min f ( y ) = 2 1 y ⊤ Σ y − i = 1 ∑ n b i ln y i , 其中 b i > 0 b_i > 0 b i > 0 ∑ b i = 1 \sum b_i = 1 ∑ b i = 1 b i = 1 / n b_i = 1/n b i = 1/ n
∇ f ( y ) = Σ y − b y , 其中 ( b y ) i = b i y i .
\nabla f(\mathbf{y}) = \Sigma \mathbf{y} - \frac{\mathbf{b}}{\mathbf{y}}, \quad \text{其中 } \left(\frac{\mathbf{b}}{\mathbf{y}}\right)_i = \frac{b_i}{y_i}.
∇ f ( y ) = Σ y − y b , 其中 ( y b ) i = y i b i . Hessian 矩阵为:
∇ 2 f ( y ) = Σ + diag ( b y 2 ) .
\nabla^2 f(\mathbf{y}) = \Sigma + \operatorname{diag}\left( \frac{\mathbf{b}}{\mathbf{y}^2} \right).
∇ 2 f ( y ) = Σ + diag ( y 2 b ) . 只要 Σ ⪰ 0 \Sigma \succeq 0 Σ ⪰ 0 b i > 0 b_i > 0 b i > 0 ∇ 2 f ( y ) ≻ 0 \nabla^2 f(\mathbf{y}) \succ 0 ∇ 2 f ( y ) ≻ 0 y > 0 \mathbf{y}>\mathbf{0} y > 0 Σ ≻ 0 \Sigma\succ0 Σ ≻ 0 Σ = [ 1 1 1 1 ] \Sigma=\begin{bmatrix}1&1\\1&1\end{bmatrix} Σ = [ 1 1 1 1 ] b 1 = b 2 = 1 / 2 b_1=b_2=1/2 b 1 = b 2 = 1/2 y = ( 1 / 2 , 1 / 2 ) ⊤ \mathbf y=(1/2,1/2)^\top y = ( 1/2 , 1/2 ) ⊤ v ≥ 0 \mathbf{v}\ge\mathbf{0} v ≥ 0 v ⊤ Σ v = 0 \mathbf{v}^\top\Sigma\mathbf{v}=0 v ⊤ Σ v = 0 y = y 0 + t v \mathbf y=\mathbf y_0+t\mathbf v y = y 0 + t v y 0 > 0 \mathbf y_0>0 y 0 > 0 t → ∞ t\to\infty t → ∞ Σ v = 0 \Sigma\mathbf v=0 Σ v = 0
( Σ y ∗ ) i − b i y i ∗ = 0 ⟺ y i ∗ ( Σ y ∗ ) i = b i .
(\Sigma \mathbf{y}^*)_i - \frac{b_i}{y_i^*} = 0 \iff y_i^* (\Sigma \mathbf{y}^*)_i = b_i.
( Σ y ∗ ) i − y i ∗ b i = 0 ⟺ y i ∗ ( Σ y ∗ ) i = b i . 由于方差贡献 y i ( Σ y ) i y_i(\Sigma\mathbf y)_i y i ( Σ y ) i y \mathbf{y} y y i ( Σ y ) i / σ ( y ) y_i(\Sigma\mathbf y)_i/\sigma(\mathbf y) y i ( Σ y ) i / σ ( y ) y ∗ \mathbf{y}^* y ∗
w ∗ = y ∗ ∑ j = 1 n y j ∗ .
\mathbf{w}^* = \frac{\mathbf{y}^*}{\sum_{j=1}^n y_j^*}.
w ∗ = ∑ j = 1 n y j ∗ y ∗ . 归一化不改变各资产风险贡献的相对比例:
w i ∗ ( Σ w ∗ ) i = y i ∗ ( Σ y ∗ ) i ( ∑ y j ∗ ) 2 = b i ( ∑ y j ∗ ) 2 ∝ b i .
w_i^*(\Sigma \mathbf{w}^*)_i = \frac{y_i^* (\Sigma \mathbf{y}^*)_i}{\left(\sum y_j^*\right)^2} = \frac{b_i}{\left(\sum y_j^*\right)^2} \propto b_i.
w i ∗ ( Σ w ∗ ) i = ( ∑ y j ∗ ) 2 y i ∗ ( Σ y ∗ ) i = ( ∑ y j ∗ ) 2 b i ∝ b i . 还需核对分母。令 s = ∑ j y j ∗ s=\sum_j y_j^* s = ∑ j y j ∗ y ∗ ⊤ Σ y ∗ = ∑ i b i = 1 \mathbf y^{*\top}\Sigma\mathbf y^*=\sum_i b_i=1 y ∗ ⊤ Σ y ∗ = ∑ i b i = 1
σ 2 ( w ∗ ) = 1 / s 2 , w i ∗ ( Σ w ∗ ) i σ 2 ( w ∗ ) = b i / s 2 1 / s 2 = b i .
\sigma^2(\mathbf w^*)=1/s^2,\qquad
\frac{w_i^*(\Sigma\mathbf w^*)_i}{\sigma^2(\mathbf w^*)}
=\frac{b_i/s^2}{1/s^2}=b_i.
σ 2 ( w ∗ ) = 1/ s 2 , σ 2 ( w ∗ ) w i ∗ ( Σ w ∗ ) i = 1/ s 2 b i / s 2 = b i . 这一步证明风险预算比例,而不是预算金额。上面的两资产例中取 y = ( 0.6 , 0.4 ) ⊤ / 0.03456 \mathbf y=(0.6,0.4)^\top/\sqrt{0.03456} y = ( 0.6 , 0.4 ) ⊤ / 0.03456
阻尼 Newton 算法与停止准则 :
初始点:取对角阵逆标准差点 y ( 0 ) = ( 1 / Σ 11 , … , 1 / Σ n n ) ⊤ \mathbf{y}^{(0)} = (1/\sqrt{\Sigma_{11}}, \dots, 1/\sqrt{\Sigma_{nn}})^\top y ( 0 ) = ( 1/ Σ 11 , … , 1/ Σ nn ) ⊤ y ⊤ Σ y = 1 \mathbf{y}^\top \Sigma \mathbf{y} = 1 y ⊤ Σ y = 1
计算 Newton 方向:Δ y = − [ ∇ 2 f ( y ) ] − 1 ∇ f ( y ) \Delta \mathbf{y} = -[\nabla^2 f(\mathbf{y})]^{-1}\nabla f(\mathbf{y}) Δ y = − [ ∇ 2 f ( y ) ] − 1 ∇ f ( y )
计算 Newton 减量(Newton decrement, Boyd & Vandenberghe §9.5):
λ 2 = − ∇ f ( y ) ⊤ Δ y .
\lambda^2 = -\nabla f(\mathbf{y})^\top \Delta \mathbf{y}.
λ 2 = − ∇ f ( y ) ⊤ Δ y . λ 2 / 2 \lambda^2/2 λ 2 /2 f ( y ) − f ∗ f(\mathbf{y}) - f^* f ( y ) − f ∗ λ 2 ≤ 10 − 14 \lambda^2 \le 10^{-14} λ 2 ≤ 1 0 − 14
回溯线搜索(Backtracking Line Search):使用 Armijo 条件确定步长 α ∈ ( 0 , 1 ] \alpha \in (0, 1] α ∈ ( 0 , 1 ] y + α Δ y > 0 \mathbf{y} + \alpha \Delta \mathbf{y} > \mathbf{0} y + α Δ y > 0
6.4 Black–Litterman 模型的贝叶斯推导与增益形式
Black–Litterman 模型把市场均衡隐含收益与投资者观点合成一个期望收益向量。Black 与 Litterman(1992)原文本章未取得;以下设定与公式依据 He 与 Litterman(1999)Appendix B。
反向优化(Reverse Optimization)确定先验 :
假设全市场投资者整体持有市场投资组合 w m k t \mathbf{w}_{mkt} w mk t Π \boldsymbol{\Pi} Π
Π = δ Σ w m k t ,
\boldsymbol{\Pi} = \delta \Sigma \mathbf{w}_{mkt},
Π = δ Σ w mk t , 其中 δ \delta δ δ = 2.5 \delta = 2.5 δ = 2.5
先验分布 :
将期望收益向量本身视为随机变量,服从以均衡收益为中心的先验正态分布:
μ ∼ N ( Π , τ Σ ) ,
\boldsymbol{\mu} \sim N(\boldsymbol{\Pi}, \tau \Sigma),
μ ∼ N ( Π , τ Σ ) , 其中标量 τ > 0 \tau > 0 τ > 0
观点体系(Views) :
投资者持有 k k k
P μ = Q + ε , ε ∼ N ( 0 , Ω ) ,
P \boldsymbol{\mu} = \mathbf{Q} + \boldsymbol{\varepsilon}, \quad \boldsymbol{\varepsilon} \sim N(\mathbf{0}, \Omega),
P μ = Q + ε , ε ∼ N ( 0 , Ω ) , 其中 P ∈ R k × n P \in \mathbb{R}^{k \times n} P ∈ R k × n Q ∈ R k \mathbf{Q} \in \mathbb{R}^k Q ∈ R k Ω ∈ R k × k \Omega \in \mathbb{R}^{k \times k} Ω ∈ R k × k
后验分布推导(分块正态条件更新) :
μ \boldsymbol{\mu} μ v = P μ + ε \mathbf{v} = P\boldsymbol{\mu} + \boldsymbol{\varepsilon} v = P μ + ε
[ μ v ] ∼ N ( [ Π P Π ] , [ τ Σ τ Σ P ⊤ P τ Σ P τ Σ P ⊤ + Ω ] ) .
\begin{bmatrix} \boldsymbol{\mu} \\ \mathbf{v} \end{bmatrix} \sim N\left( \begin{bmatrix} \boldsymbol{\Pi} \\ P\boldsymbol{\Pi} \end{bmatrix}, \begin{bmatrix} \tau \Sigma & \tau \Sigma P^\top \\ P \tau \Sigma & P \tau \Sigma P^\top + \Omega \end{bmatrix} \right).
[ μ v ] ∼ N ( [ Π P Π ] , [ τ Σ P τ Σ τ Σ P ⊤ P τ Σ P ⊤ + Ω ] ) . 应用条件正态分布公式,后验期望收益率均值 μ B L \boldsymbol{\mu}_{BL} μ B L V B L V_{BL} V B L
μ B L = Π + τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 ( Q − P Π ) ,
\boldsymbol{\mu}_{BL} = \boldsymbol{\Pi} + \tau \Sigma P^\top (P \tau \Sigma P^\top + \Omega)^{-1}(\mathbf{Q} - P\boldsymbol{\Pi}),
μ B L = Π + τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 ( Q − P Π ) , V B L = τ Σ − τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 P τ Σ .
V_{BL} = \tau \Sigma - \tau \Sigma P^\top (P \tau \Sigma P^\top + \Omega)^{-1} P \tau \Sigma.
V B L = τ Σ − τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 P τ Σ. 定义 Kalman 形式的增益矩阵 M = τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 M = \tau \Sigma P^\top (P \tau \Sigma P^\top + \Omega)^{-1} M = τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1
μ B L = Π + M ( Q − P Π ) .
\boldsymbol{\mu}_{BL} = \boldsymbol{\Pi} + M(\mathbf{Q} - P\boldsymbol{\Pi}).
μ B L = Π + M ( Q − P Π ) . 该增益形式不要求 Ω \Omega Ω S v = P τ Σ P ⊤ + Ω S_v=P\tau\Sigma P^\top+\Omega S v = P τ Σ P ⊤ + Ω Ω = 0 \Omega=0 Ω = 0 Σ ≻ 0 \Sigma\succ0 Σ ≻ 0 τ > 0 \tau>0 τ > 0 P P P S v S_v S v V B L V_{BL} V B L R = μ + ε R=\mu+\varepsilon R = μ + ε Cov ( ε ) = Σ \operatorname{Cov}(\varepsilon)=\Sigma Cov ( ε ) = Σ Σ + V B L \Sigma+V_{BL} Σ + V B L Σ \Sigma Σ
最优持仓倾斜的正交性质 :
将后验均值代入均值方差最优配置:
w ∗ = ( δ Σ ) − 1 μ B L = ( δ Σ ) − 1 [ δ Σ w m k t + τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 ( Q − P Π ) ] .
\mathbf{w}^* = (\delta \Sigma)^{-1}\boldsymbol{\mu}_{BL} = (\delta \Sigma)^{-1}\left[\delta \Sigma \mathbf{w}_{mkt} + \tau \Sigma P^\top (P \tau \Sigma P^\top + \Omega)^{-1}(\mathbf{Q} - P\boldsymbol{\Pi})\right].
w ∗ = ( δ Σ ) − 1 μ B L = ( δ Σ ) − 1 [ δ Σ w mk t + τ Σ P ⊤ ( P τ Σ P ⊤ + Ω ) − 1 ( Q − P Π ) ] . 展开整理可得:
w ∗ = w m k t + P ⊤ [ τ δ ( P τ Σ P ⊤ + Ω ) − 1 ( Q − P Π ) ] = w m k t + P ⊤ λ .
\mathbf{w}^* = \mathbf{w}_{mkt} + P^\top \left[ \frac{\tau}{\delta}(P \tau \Sigma P^\top + \Omega)^{-1}(\mathbf{Q} - P\boldsymbol{\Pi}) \right] = \mathbf{w}_{mkt} + P^\top \boldsymbol{\lambda}.
w ∗ = w mk t + P ⊤ [ δ τ ( P τ Σ P ⊤ + Ω ) − 1 ( Q − P Π ) ] = w mk t + P ⊤ λ . 此式说明:无约束权重相对市场权重的偏离位于 P ⊤ P^\top P ⊤ P P P
6.5 Kelly 准则与对数增长率推导
Kelly(1956)探讨了使长期财富几何增长率最大化的资金管理法则。
离散二元下注 :
设投资者下注比例为 f ∈ [ 0 , 1 ) f \in [0, 1) f ∈ [ 0 , 1 ) p p p b b b b b b
g ( f ) = E [ ln ( W t + 1 / W t ) ] = p ln ( 1 + b f ) + ( 1 − p ) ln ( 1 − f ) .
g(f) = E[\ln(W_{t+1}/W_t)] = p \ln(1 + bf) + (1 - p)\ln(1 - f).
g ( f ) = E [ ln ( W t + 1 / W t )] = p ln ( 1 + b f ) + ( 1 − p ) ln ( 1 − f ) . 对 f f f
g ′ ( f ) = p b 1 + b f − 1 − p 1 − f .
g'(f) = \frac{pb}{1 + bf} - \frac{1 - p}{1 - f}.
g ′ ( f ) = 1 + b f p b − 1 − f 1 − p . 令 g ′ ( f ) = 0 g'(f) = 0 g ′ ( f ) = 0
p b ( 1 − f ) = ( 1 − p ) ( 1 + b f ) ⟹ p b − p b f = 1 − p + b f − p b f ⟹ b f = p b − ( 1 − p ) .
pb(1 - f) = (1 - p)(1 + bf) \implies pb - pbf = 1 - p + bf - pbf \implies bf = pb - (1 - p).
p b ( 1 − f ) = ( 1 − p ) ( 1 + b f ) ⟹ p b − p b f = 1 − p + b f − p b f ⟹ b f = p b − ( 1 − p ) . 解得著名的 Kelly 最优下注比例:
f ∗ = p − 1 − p b = b p − ( 1 − p ) b .
f^* = p - \frac{1 - p}{b} = \frac{bp - (1 - p)}{b}.
f ∗ = p − b 1 − p = b b p − ( 1 − p ) . 若赔率对称(b = 1 b = 1 b = 1 f ∗ = 2 p − 1 f^* = 2p - 1 f ∗ = 2 p − 1 b p ≤ 1 − p bp\le 1-p b p ≤ 1 − p g ′ ( 0 ) = p b − ( 1 − p ) ≤ 0 g'(0)=pb-(1-p)\le0 g ′ ( 0 ) = p b − ( 1 − p ) ≤ 0 g g g f > 0 f>0 f > 0 f ∗ = max { ( b p − ( 1 − p ) ) / b , 0 } f^*=\max\{(bp-(1-p))/b,\,0\} f ∗ = max {( b p − ( 1 − p )) / b , 0 } 记号对照 :Kelly(1956)原论文在 Bell System Technical Journal 印刷页 920 中,使用字母 q q q p p p ℓ \ell ℓ p p p 1 − p 1-p 1 − p f f f
离散资产配置的二阶展开与二次代理 :
对于连续收益资产,设单期超额收益为 r − r f 1 \mathbf{r} - r_f \mathbf{1} r − r f 1 m \mathbf{m} m Σ \Sigma Σ
ln ( 1 + r p ) ≈ r p − 1 2 r p 2 .
\ln(1 + r_p) \approx r_p - \frac{1}{2}r_p^2.
ln ( 1 + r p ) ≈ r p − 2 1 r p 2 . 令 a = E [ r p ] = r f + w ⊤ m a=E[r_p]=r_f+\mathbf w^\top\mathbf m a = E [ r p ] = r f + w ⊤ m r f r_f r f E [ r p 2 ] = Var ( r p ) + a 2 = w ⊤ Σ w + a 2 E[r_p^2]=\operatorname{Var}(r_p)+a^2=\mathbf w^\top\Sigma\mathbf w+a^2 E [ r p 2 ] = Var ( r p ) + a 2 = w ⊤ Σ w + a 2
g 2 , d ( w ) = a − 1 2 [ w ⊤ Σ w + a 2 ] .
g_{2,d}(\mathbf w)=a-\tfrac12\left[\mathbf w^\top\Sigma\mathbf w+a^2\right].
g 2 , d ( w ) = a − 2 1 [ w ⊤ Σ w + a 2 ] . 不能把 a 2 a^2 a 2 r p r_p r p a = 0.15 a=0.15 a = 0.15
以下代码采用再忽略漂移平方的局部模型:
g q ( w ) = r f + w ⊤ m − 1 2 w ⊤ Σ w .
g_q(\mathbf{w}) = r_f + \mathbf{w}^\top \mathbf{m} - \frac{1}{2}\mathbf{w}^\top \Sigma \mathbf{w}.
g q ( w ) = r f + w ⊤ m − 2 1 w ⊤ Σ w . 这是额外近似。当时间步 Δ t \Delta t Δ t O ( Δ t ) O(\Delta t) O ( Δ t ) O ( Δ t ) O(\Delta t) O ( Δ t ) a 2 = O ( Δ t 2 ) a^2=O(\Delta t^2) a 2 = O ( Δ t 2 ) quadratic_log_growth只计算 g q g_q g q gaussian_kelly_weights只优化这个明确的代理目标。对完整离散二阶式,梯度是 ( 1 − a ) m − Σ w (1-a)\mathbf m-\Sigma\mathbf w ( 1 − a ) m − Σ w ( 1 − r f ) ( Σ + m m ⊤ ) − 1 m (1-r_f)(\Sigma+\mathbf m\mathbf m^\top)^{-1}\mathbf m ( 1 − r f ) ( Σ + m m ⊤ ) − 1 m Σ − 1 m \Sigma^{-1}\mathbf m Σ − 1 m w \mathbf{w} w
∇ g ( w ) = m − Σ w = 0 ⟹ w ∗ = Σ − 1 m .
\nabla g(\mathbf{w}) = \mathbf{m} - \Sigma \mathbf{w} = \mathbf{0} \implies \mathbf{w}^* = \Sigma^{-1}\mathbf{m}.
∇ g ( w ) = m − Σ w = 0 ⟹ w ∗ = Σ − 1 m . 这里 w ∗ \mathbf{w}^* w ∗ 1 − 1 ⊤ w ∗ 1-\mathbf{1}^\top\mathbf{w}^* 1 − 1 ⊤ w ∗ w ∗ = 3.2 w^*=3.2 w ∗ = 3.2 c ∈ ( 0 , 1 ] c \in (0, 1] c ∈ ( 0 , 1 ] w c = c w ∗ \mathbf{w}_c = c \mathbf{w}^* w c = c w ∗
增长率比例:g ( c w ∗ ) − r f = c w ∗ ⊤ m − 1 2 c 2 w ∗ ⊤ Σ w ∗ = ( 2 c − c 2 ) [ 1 2 m ⊤ Σ − 1 m ] g(c\mathbf{w}^*) - r_f = c \mathbf{w}^{*\top}\mathbf{m} - \frac{1}{2}c^2 \mathbf{w}^{*\top}\Sigma \mathbf{w}^* = (2c - c^2)\left[ \frac{1}{2}\mathbf{m}^\top \Sigma^{-1}\mathbf{m} \right] g ( c w ∗ ) − r f = c w ∗ ⊤ m − 2 1 c 2 w ∗ ⊤ Σ w ∗ = ( 2 c − c 2 ) [ 2 1 m ⊤ Σ − 1 m ]
收益方差比例:Var ( c w ∗ ) = c 2 Var ( w ∗ ) \operatorname{Var}(c\mathbf{w}^*) = c^2 \operatorname{Var}(\mathbf{w}^*) Var ( c w ∗ ) = c 2 Var ( w ∗ ) c = 0.5 c = 0.5 c = 0.5
在上述二次代理目标下,超过现金增长基准的部分为全额 Kelly 的 2 ( 0.5 ) − 0.5 2 = 75 % 2(0.5) - 0.5^2 = 75\% 2 ( 0.5 ) − 0. 5 2 = 75%
同一输入协方差下方差为全额 Kelly 的 0.5 2 = 25 % 0.5^2 = 25\% 0. 5 2 = 25% r p ≤ − 1 r_p\le-1 r p ≤ − 1 E ln ( 1 + r p ) E\ln(1+r_p) E ln ( 1 + r p ) m \mathbf{m} m
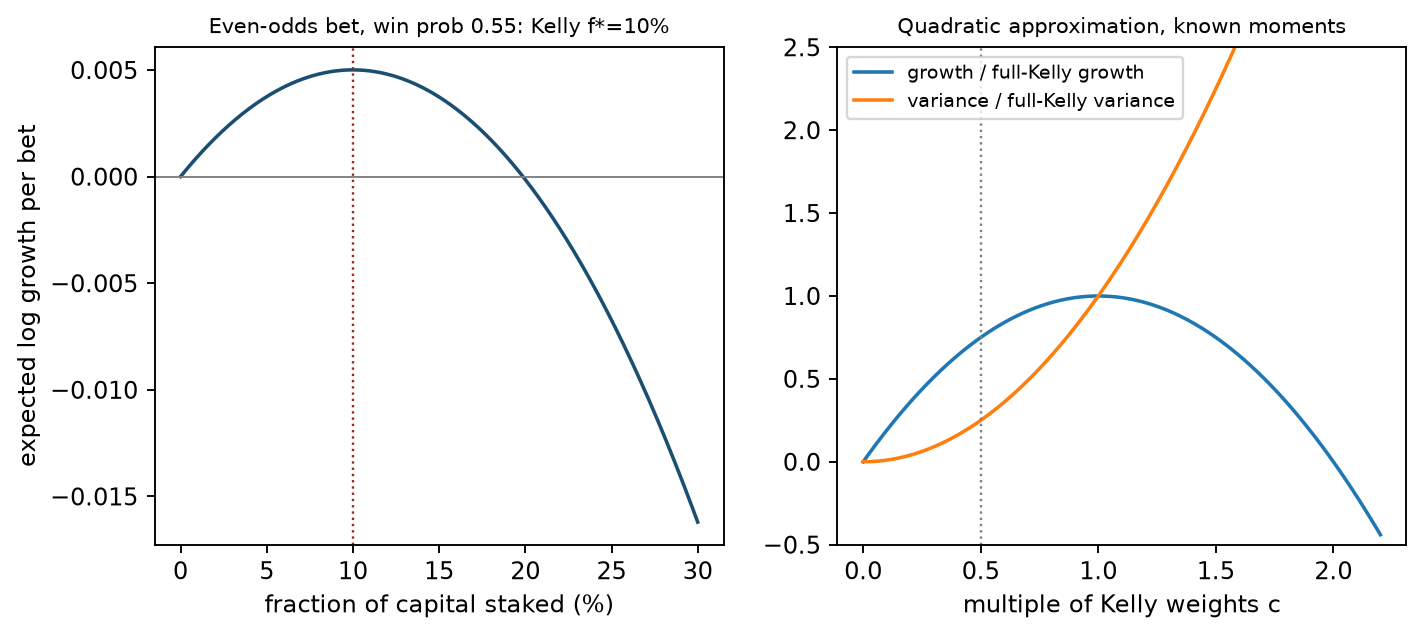
Kelly 准则增长率与方差权衡曲线
横轴 :左图为下注资金比例 f f f % \% % c c c 纵轴 :左图为每期期望对数增长率,右图为相对全额 Kelly 的增长率倍数与方差倍数;读法与观察点 :
左图展示 p = 0.55 , b = 1 p = 0.55, b = 1 p = 0.55 , b = 1 f ∗ = 10 % f^* = 10\% f ∗ = 10% 0.005008 0.005008 0.005008 f = 20 % f = 20\% f = 20%
右图展示高斯近似下,半 Kelly(c = 0.5 c = 0.5 c = 0.5 75 % 75\% 75% 25 % 25\% 25%
局限性 :右图只是已知矩、忽略均值平方项的二次增长代理;75% 指现金基准以上的代理增长。高斯简单收益也有无界左尾,不能保证精确对数效用存在;厚尾、跳跃、融资和保证金约束会进一步改变可承受仓位。
6.6 因子风险分解
第 15 章的因子模型 r = B f + ε \mathbf{r}=B\mathbf{f}+\boldsymbol{\varepsilon} r = B f + ε B B B n × K n\times K n × K Cov ( f ) = Σ f \operatorname{Cov}(\mathbf{f})=\Sigma_f Cov ( f ) = Σ f Σ ε \Sigma_\varepsilon Σ ε Ω \Omega Ω Σ = B Σ f B ⊤ + Σ ε \Sigma=B\Sigma_fB^\top+\Sigma_\varepsilon Σ = B Σ f B ⊤ + Σ ε β p = B ⊤ w \boldsymbol{\beta}_p=B^\top\mathbf{w} β p = B ⊤ w K × 1 K\times1 K × 1
w ⊤ Σ w = β p ⊤ Σ f β p + w ⊤ Σ ε w .
\mathbf{w}^\top\Sigma\mathbf{w}=\boldsymbol{\beta}_p^\top\Sigma_f\boldsymbol{\beta}_p+\mathbf{w}^\top\Sigma_\varepsilon\mathbf{w}.
w ⊤ Σ w = β p ⊤ Σ f β p + w ⊤ Σ ε w . 资产 i i i w i ( Σ w ) i w_i(\Sigma\mathbf{w})_i w i ( Σ w ) i w i ( B Σ f β p ) i w_i(B\Sigma_f\boldsymbol{\beta}_p)_i w i ( B Σ f β p ) i w i 2 ( Σ ε ) i i w_i^2(\Sigma_\varepsilon)_{ii} w i 2 ( Σ ε ) ii β = ( 1.1 , 0.9 ) \boldsymbol{\beta}=(1.1,0.9) β = ( 1.1 , 0.9 ) Σ f = 0.03 \Sigma_f=0.03 Σ f = 0.03 Σ ε = diag ( 0.02 , 0.01 ) \Sigma_\varepsilon=\operatorname{diag}(0.02,0.01) Σ ε = diag ( 0.02 , 0.01 ) w = ( 0.5 , 0.5 ) \mathbf{w}=(0.5,0.5) w = ( 0.5 , 0.5 ) β p = 1.0 \beta_p=1.0 β p = 1.0 0.03 0.03 0.03 0.25 ( 0.02 ) + 0.25 ( 0.01 ) = 0.0075 0.25(0.02)+0.25(0.01)=0.0075 0.25 ( 0.02 ) + 0.25 ( 0.01 ) = 0.0075 0.0375 0.0375 0.0375 0.5 ( 1.1 ) ( 0.03 ) ( 1.0 ) = 0.0165 0.5(1.1)(0.03)(1.0)=0.0165 0.5 ( 1.1 ) ( 0.03 ) ( 1.0 ) = 0.0165 0.005 0.005 0.005 0.0135 0.0135 0.0135 0.0025 0.0025 0.0025 0.0375 0.0375 0.0375
7. 金融解释:杠杆、成本与分散化幻觉
7.1 杠杆与头寸暴露口径
多空量化策略必须严格区分两套持仓口径:
净暴露(Net Exposure) :∑ i = 1 n w i \sum_{i=1}^n w_i ∑ i = 1 n w i 总暴露(Gross Exposure) :∑ i = 1 n ∣ w i ∣ \sum_{i=1}^n |w_i| ∑ i = 1 n ∣ w i ∣ 200 % 200\% 200% 名义杠杆(Leverage) :当权重已按净资产值归一化时,就是总暴露 ∑ i ∣ w i ∣ \sum_i|w_i| ∑ i ∣ w i ∣
7.2 交易摩擦、持仓漂移与换手拖累
在一个完整的投资周期中,资产权重的变动由两部分构成:价格被动变动带来的“漂移(drift)”与经理主动调仓带来的“换手(turnover)”。
设期初持仓权重为 w \mathbf{w} w ∑ w i = 1 \sum w_i = 1 ∑ w i = 1 r = ( r 1 , … , r n ) ⊤ \mathbf{r} = (r_1, \dots, r_n)^\top r = ( r 1 , … , r n ) ⊤ i i i
w i + = w i ( 1 + r i ) 1 + w ⊤ r .
w_i^+ = \frac{w_i (1 + r_i)}{1 + \mathbf{w}^\top \mathbf{r}}.
w i + = 1 + w ⊤ r w i ( 1 + r i ) . 若下期目标权重为 w t a r g e t \mathbf{w}^{target} w t a r g e t
Turnover = ∑ i = 1 n ∣ w i t a r g e t − w i + ∣ .
\operatorname{Turnover} = \sum_{i=1}^n |w_i^{target} - w_i^+|.
Turnover = i = 1 ∑ n ∣ w i t a r g e t − w i + ∣. 若单边交易成本率为 c c c c = 0.0010 c = 0.0010 c = 0.0010 c × Turnover c \times \operatorname{Turnover} c × Turnover
r n e t = ( 1 − c ⋅ Turnover ) ( 1 + r g r o s s ) − 1.
r_{net} = (1 - c \cdot \operatorname{Turnover})(1 + r_{gross}) - 1.
r n e t = ( 1 − c ⋅ Turnover ) ( 1 + r g r oss ) − 1. 它不是精确自融资成交金额账本:真实交易金额还取决于扣费后净值,费用比例 q q q q = c ∑ i ∣ ( 1 − q ) w i t a r g e t − w i + ∣ q=c\sum_i|(1-q)w_i^{target}-w_i^+| q = c ∑ i ∣ ( 1 − q ) w i t a r g e t − w i + ∣ q ≈ c Turnover q\approx c\operatorname{Turnover} q ≈ c Turnover 12 E [ q ] 12E[q] 12 E [ q ] 12 E [ q ( 1 + r g r o s s ) ] 12E[q(1+r_{gross})] 12 E [ q ( 1 + r g r oss )]
7.3 分散化幻觉与几何投影的破灭
直觉上,组合持有越多资产似乎风险越分散。但如果风险贡献极端不均,投资者便陷入了分散化幻觉(diversification illusion) 。
构造例:股票年化波动 16%、债券 5%、相关 0.2,资金 60% 股票、40% 债券。下标 s 表示股票、b 表示债券:( Σ w ) s = 0.6 ( 0.0256 ) + 0.4 ( 0.2 ) ( 0.16 ) ( 0.05 ) = 0.016 (\Sigma\mathbf{w})_{s}=0.6(0.0256)+0.4(0.2)(0.16)(0.05)=0.016 ( Σ w ) s = 0.6 ( 0.0256 ) + 0.4 ( 0.2 ) ( 0.16 ) ( 0.05 ) = 0.016 ( Σ w ) b = 0.4 ( 0.0025 ) + 0.6 ( 0.0016 ) = 0.00196 (\Sigma\mathbf{w})_{b}=0.4(0.0025)+0.6(0.0016)=0.00196 ( Σ w ) b = 0.4 ( 0.0025 ) + 0.6 ( 0.0016 ) = 0.00196 0.6 ( 0.016 ) + 0.4 ( 0.00196 ) = 0.010384 0.6(0.016)+0.4(0.00196)=0.010384 0.6 ( 0.016 ) + 0.4 ( 0.00196 ) = 0.010384 0.0096 / 0.010384 = 92.4 % 0.0096/0.010384=92.4\% 0.0096/0.010384 = 92.4%
另一类常见的认知误区是试图通过“欧氏空间投影”来满足中性约束。
设原始 Alpha 模型给出了权重 w \mathbf{w} w A w = 0 A\mathbf{w} = \mathbf{0} A w = 0
min v ∥ v − w ∥ 2 2 s.t. A v = 0 ,
\min_{\mathbf{v}} \|\mathbf{v} - \mathbf{w}\|_2^2 \quad \text{s.t.} \quad A\mathbf{v} = \mathbf{0},
v min ∥ v − w ∥ 2 2 s.t. A v = 0 , 其闭式解为:
v ∗ = w − A ⊤ ( A A ⊤ ) − 1 A w .
\mathbf{v}^* = \mathbf{w} - A^\top(AA^\top)^{-1}A\mathbf{w}.
v ∗ = w − A ⊤ ( A A ⊤ ) − 1 A w . 这种操作的严重金融缺陷在于:欧氏距离最小化是在没有任何金融维度的纯数学抽象空间进行的。它完全不感知各个资产的波动率高低、相关性强弱和流动性摩擦。约束行彼此相关时,投影可能大幅缩减原有多空权重(第 8.3 节总暴露从 1.6 降到 0.2)。它是否保留了预期收益来源,需要用风险模型和收益预测重新评估;更常见的做法是把中性条件作为约束放进带风险项的优化。
8. 数值算例(Numerical Examples)
本节提供 5 组具有明确输入、逐步手算核对过程与确定单位的基准数值例。
8.1 Ledoit–Wolf 协方差收缩手算例(4×2 矩阵,百分数单位)
完整例题:逐项计算协方差收缩
输入 :
训练窗口包含 T = 4 T = 4 T = 4 p = 2 p = 2 p = 2
X = [ 3.0 2.0 − 1.0 − 2.0 2.0 3.0 − 4.0 − 3.0 ] .
X = \begin{bmatrix} 3.0 & 2.0 \\ -1.0 & -2.0 \\ 2.0 & 3.0 \\ -4.0 & -3.0 \end{bmatrix}.
X = 3.0 − 1.0 2.0 − 4.0 2.0 − 2.0 3.0 − 3.0 . 手算步骤 :
样本协方差矩阵 S = 1 T X ⊤ X S = \frac{1}{T}X^\top X S = T 1 X ⊤ X :
( X ⊤ X ) 11 = 3 2 + ( − 1 ) 2 + 2 2 + ( − 4 ) 2 = 30 , ( X ⊤ X ) 12 = 3 ( 2 ) + ( − 1 ) ( − 2 ) + 2 ( 3 ) + ( − 4 ) ( − 3 ) = 26 , ( X ⊤ X ) 22 = 2 2 + ( − 2 ) 2 + 3 2 + ( − 3 ) 2 = 26.
\begin{aligned}
(X^\top X)_{11}&=3^2+(-1)^2+2^2+(-4)^2=30,\\
(X^\top X)_{12}&=3(2)+(-1)(-2)+2(3)+(-4)(-3)=26,\\
(X^\top X)_{22}&=2^2+(-2)^2+3^2+(-3)^2=26.
\end{aligned}
( X ⊤ X ) 11 ( X ⊤ X ) 12 ( X ⊤ X ) 22 = 3 2 + ( − 1 ) 2 + 2 2 + ( − 4 ) 2 = 30 , = 3 ( 2 ) + ( − 1 ) ( − 2 ) + 2 ( 3 ) + ( − 4 ) ( − 3 ) = 26 , = 2 2 + ( − 2 ) 2 + 3 2 + ( − 3 ) 2 = 26. 除以 T = 4 T = 4 T = 4
S = [ 7.5 6.5 6.5 6.5 ] .
S = \begin{bmatrix} 7.5 & 6.5 \\ 6.5 & 6.5 \end{bmatrix}.
S = [ 7.5 6.5 6.5 6.5 ] .
收缩目标尺度 m m m :
m = 1 p tr ( S ) = 7.5 + 6.5 2 = 7.0.
m = \frac{1}{p}\operatorname{tr}(S) = \frac{7.5 + 6.5}{2} = 7.0.
m = p 1 tr ( S ) = 2 7.5 + 6.5 = 7.0.
样本偏离度平方 d 2 = ∥ S − m I ∥ 2 d^2 = \|S - mI\|^2 d 2 = ∥ S − m I ∥ 2 :
S − m I = [ 7.5 − 7.0 6.5 6.5 6.5 − 7.0 ] = [ 0.5 6.5 6.5 − 0.5 ] .
S - mI = \begin{bmatrix} 7.5 - 7.0 & 6.5 \\ 6.5 & 6.5 - 7.0 \end{bmatrix} = \begin{bmatrix} 0.5 & 6.5 \\ 6.5 & -0.5 \end{bmatrix}.
S − m I = [ 7.5 − 7.0 6.5 6.5 6.5 − 7.0 ] = [ 0.5 6.5 6.5 − 0.5 ] . Frobenius 范数平方(除以 p = 2 p = 2 p = 2
d 2 = 1 2 ( 0.5 2 + 6.5 2 + 6.5 2 + ( − 0.5 ) 2 ) = 1 2 ( 0.25 + 42.25 + 42.25 + 0.25 ) = 85.0 2 = 42.5.
d^2 = \frac{1}{2}\left( 0.5^2 + 6.5^2 + 6.5^2 + (-0.5)^2 \right) = \frac{1}{2}(0.25 + 42.25 + 42.25 + 0.25) = \frac{85.0}{2} = 42.5.
d 2 = 2 1 ( 0. 5 2 + 6. 5 2 + 6. 5 2 + ( − 0.5 ) 2 ) = 2 1 ( 0.25 + 42.25 + 42.25 + 0.25 ) = 2 85.0 = 42.5.
误差方差估计量 b ˉ 2 \bar{b}^2 b ˉ 2 :
计算每行范数平方 ∥ x t ∥ 2 2 \|\mathbf{x}_t\|_2^2 ∥ x t ∥ 2 2
t = 1 t = 1 t = 1 3 2 + 2 2 = 13 3^2 + 2^2 = 13 3 2 + 2 2 = 13 13 2 = 169 13^2 = 169 1 3 2 = 169 t = 2 t = 2 t = 2 ( − 1 ) 2 + ( − 2 ) 2 = 5 (-1)^2 + (-2)^2 = 5 ( − 1 ) 2 + ( − 2 ) 2 = 5 5 2 = 25 5^2 = 25 5 2 = 25 t = 3 t = 3 t = 3 2 2 + 3 2 = 13 2^2 + 3^2 = 13 2 2 + 3 2 = 13 13 2 = 169 13^2 = 169 1 3 2 = 169 t = 4 t = 4 t = 4 ( − 4 ) 2 + ( − 3 ) 2 = 25 (-4)^2 + (-3)^2 = 25 ( − 4 ) 2 + ( − 3 ) 2 = 25 25 2 = 625 25^2 = 625 2 5 2 = 625 ∑ t = 1 4 ∥ x t ∥ 2 4 = 169 + 25 + 169 + 625 = 988 \sum_{t=1}^4 \|\mathbf{x}_t\|_2^4 = 169 + 25 + 169 + 625 = 988 ∑ t = 1 4 ∥ x t ∥ 2 4 = 169 + 25 + 169 + 625 = 988
∑ i , j s i j 2 = 7.5 2 + 6.5 2 + 6.5 2 + 6.5 2 = 56.25 + 3 ( 42.25 ) = 56.25 + 126.75 = 183.0.
\sum_{i,j} s_{ij}^2 = 7.5^2 + 6.5^2 + 6.5^2 + 6.5^2 = 56.25 + 3(42.25) = 56.25 + 126.75 = 183.0.
i , j ∑ s ij 2 = 7. 5 2 + 6. 5 2 + 6. 5 2 + 6. 5 2 = 56.25 + 3 ( 42.25 ) = 56.25 + 126.75 = 183.0. 代入公式计算 b ˉ 2 \bar{b}^2 b ˉ 2
b ˉ 2 = 988 − 4 ( 183.0 ) T 2 p = 988 − 732 4 2 × 2 = 256 32 = 8.0.
\bar{b}^2 = \frac{988 - 4(183.0)}{T^2 p} = \frac{988 - 732}{4^2 \times 2} = \frac{256}{32} = 8.0.
b ˉ 2 = T 2 p 988 − 4 ( 183.0 ) = 4 2 × 2 988 − 732 = 32 256 = 8.0.
收缩强度与收缩估计量 :
b 2 = min ( max ( 8.0 , 0 ) , 42.5 ) = 8.0 ⟹ κ ^ = b 2 d 2 = 8.0 42.5 = 16 85 ≈ 0.18823529.
b^2 = \min(\max(8.0, 0), 42.5) = 8.0 \implies \hat{\kappa} = \frac{b^2}{d^2} = \frac{8.0}{42.5} = \frac{16}{85} \approx 0.18823529.
b 2 = min ( max ( 8.0 , 0 ) , 42.5 ) = 8.0 ⟹ κ ^ = d 2 b 2 = 42.5 8.0 = 85 16 ≈ 0.18823529. 计算收缩协方差矩阵 S ∗ = κ ^ ( 7.0 I ) + ( 1 − κ ^ ) S S^* = \hat{\kappa} (7.0 I) + (1 - \hat{\kappa}) S S ∗ = κ ^ ( 7.0 I ) + ( 1 − κ ^ ) S
S 11 ∗ = 16 85 ( 7.0 ) + 69 85 ( 7.5 ) = 112 + 517.5 85 = 629.5 85 ≈ 7.40588235 S^*_{11} = \frac{16}{85}(7.0) + \frac{69}{85}(7.5) = \frac{112 + 517.5}{85} = \frac{629.5}{85} \approx 7.40588235 S 11 ∗ = 85 16 ( 7.0 ) + 85 69 ( 7.5 ) = 85 112 + 517.5 = 85 629.5 ≈ 7.40588235 S 12 ∗ = S 21 ∗ = 69 85 ( 6.5 ) = 448.5 85 ≈ 5.27647059 S^*_{12} = S^*_{21} = \frac{69}{85}(6.5) = \frac{448.5}{85} \approx 5.27647059 S 12 ∗ = S 21 ∗ = 85 69 ( 6.5 ) = 85 448.5 ≈ 5.27647059 S 22 ∗ = 16 85 ( 7.0 ) + 69 85 ( 6.5 ) = 112 + 448.5 85 = 560.5 85 ≈ 6.59411765 S^*_{22} = \frac{16}{85}(7.0) + \frac{69}{85}(6.5) = \frac{112 + 448.5}{85} = \frac{560.5}{85} \approx 6.59411765 S 22 ∗ = 85 16 ( 7.0 ) + 85 69 ( 6.5 ) = 85 112 + 448.5 = 85 560.5 ≈ 6.59411765
金融比较 :
样本相关系数:ρ = 6.5 7.5 × 6.5 = 13 15 ≈ 0.930949 \rho = \frac{6.5}{\sqrt{7.5 \times 6.5}} = \sqrt{\frac{13}{15}} \approx 0.930949 ρ = 7.5 × 6.5 6.5 = 15 13 ≈ 0.930949
收缩后相关系数:ρ ∗ = 5.27647059 7.40588235 × 6.59411765 ≈ 5.27647059 48.8352595156 ≈ 5.27647059 6.9882229154 ≈ 0.755052 \rho^* = \frac{5.27647059}{\sqrt{7.40588235 \times 6.59411765}} \approx \frac{5.27647059}{\sqrt{48.8352595156}} \approx \frac{5.27647059}{6.9882229154} \approx 0.755052 ρ ∗ = 7.40588235 × 6.59411765 5.27647059 ≈ 48.8352595156 5.27647059 ≈ 6.9882229154 5.27647059 ≈ 0.755052 0.931 0.931 0.931 0.755 0.755 0.755
8.2 漂移、换手与成本台账手算例
完整例题:漂移、换手与代理费用
输入 :
两资产组合期初等权 w = ( 0.50 , 0.50 ) \mathbf{w} = (0.50, 0.50) w = ( 0.50 , 0.50 ) r 1 = + 10.0 % r_1 = +10.0\% r 1 = + 10.0% 0.10 0.10 0.10 r 2 = − 10.0 % r_2 = -10.0\% r 2 = − 10.0% − 0.10 -0.10 − 0.10 w t a r g e t = ( 0.50 , 0.50 ) \mathbf{w}^{target} = (0.50, 0.50) w t a r g e t = ( 0.50 , 0.50 ) c = 10 bps = 0.0010 c = 10\text{ bps} = 0.0010 c = 10 bps = 0.0010 手算步骤 :
组合毛收益率:r g r o s s = 0.5 ( 0.10 ) + 0.5 ( − 0.10 ) = 0.0 r_{gross} = 0.5(0.10) + 0.5(-0.10) = 0.0 r g r oss = 0.5 ( 0.10 ) + 0.5 ( − 0.10 ) = 0.0
漂移后权重:
w 1 + = 0.5 ( 1 + 0.10 ) 1 + 0.0 = 0.55 , w 2 + = 0.5 ( 1 − 0.10 ) 1 + 0.0 = 0.45 ;
w_1^+ = \frac{0.5(1 + 0.10)}{1 + 0.0} = 0.55, \quad w_2^+ = \frac{0.5(1 - 0.10)}{1 + 0.0} = 0.45;
w 1 + = 1 + 0.0 0.5 ( 1 + 0.10 ) = 0.55 , w 2 + = 1 + 0.0 0.5 ( 1 − 0.10 ) = 0.45 ;
换手率:
Turnover = ∣ 0.50 − 0.55 ∣ + ∣ 0.50 − 0.45 ∣ = 0.05 + 0.05 = 0.10 ( 10 % NAV ) ;
\operatorname{Turnover} = |0.50 - 0.55| + |0.50 - 0.45| = 0.05 + 0.05 = 0.10 \quad (10\%\text{ NAV});
Turnover = ∣0.50 − 0.55∣ + ∣0.50 − 0.45∣ = 0.05 + 0.05 = 0.10 ( 10% NAV ) ;
交易成本拖累:cost = 0.0010 × 0.10 = 0.0001 \text{cost} = 0.0010 \times 0.10 = 0.0001 cost = 0.0010 × 0.10 = 0.0001
扣费后净收益:
r n e t = ( 1 − 0.0001 ) ( 1 + 0.0 ) − 1 = − 0.0001 ( − 0.01 % ) .
r_{net} = (1 - 0.0001)(1 + 0.0) - 1 = -0.0001 \quad (-0.01\%).
r n e t = ( 1 − 0.0001 ) ( 1 + 0.0 ) − 1 = − 0.0001 ( − 0.01% ) .
8.2.1 用金额核对精确自融资
完整例题:扣费后的金额守恒
上例目标未变,仍有成交。交易前净值 V − = 100 V^-=100 V − = 100 V + = ( 1 − q ) V − V^+=(1-q)V^- V + = ( 1 − q ) V − 50 ( 1 − q ) 50(1-q) 50 ( 1 − q ) 50 ( 1 − q ) 50(1-q) 50 ( 1 − q )
q = c ∑ i ∣ ( 1 − q ) w i t a r g e t − w i + ∣ .
q=c\sum_i|(1-q)w_i^{target}-w_i^+|.
q = c i ∑ ∣ ( 1 − q ) w i t a r g e t − w i + ∣. 在本例 c = 0.001 c=0.001 c = 0.001 q < 0.1 q<0.1 q < 0.1 0.05 + 0.5 q 0.05+0.5q 0.05 + 0.5 q 0.05 − 0.5 q 0.05-0.5q 0.05 − 0.5 q q = 0.0001 q=0.0001 q = 0.0001
改成全部转入资产1:w t a r g e t = ( 1 , 0 ) w^{target}=(1,0) w t a r g e t = ( 1 , 0 ) 0.45 − q 0.45-q 0.45 − q
q = 0.001 ( 0.90 − q ) , q = 0.0009 1.001 = 0.0008991009.
q=0.001(0.90-q),\qquad q=\frac{0.0009}{1.001}=0.0008991009.
q = 0.001 ( 0.90 − q ) , q = 1.001 0.0009 = 0.0008991009. 精确费用899.1009元;按旧净值换手0.90的代理收费900元,多0.8991元。Project3复用的是代理,不能把这里的精确手算混称项目重算结果。
长仓满仓目标下 ∑ i w i t a r g e t = 1 \sum_iw_i^{target}=1 ∑ i w i t a r g e t = 1 F ( q ) = c ∑ i ∣ ( 1 − q ) w i t a r g e t − w i + ∣ F(q)=c\sum_i|(1-q)w_i^{target}-w_i^+| F ( q ) = c ∑ i ∣ ( 1 − q ) w i t a r g e t − w i + ∣ 0 ≤ c < 1 / 2 0\le c<1/2 0 ≤ c < 1/2 F ( 0 ) ≤ 2 c < 1 F(0)\le2c<1 F ( 0 ) ≤ 2 c < 1 F ( 1 ) = c < 1 F(1)=c<1 F ( 1 ) = c < 1
这三层账本分别回答:漂移权重说明为什么交易;代理便于冻结规格比较;精确式保证指定比例费用模型的资金守恒。Project3没有订单、冲击和成交日志,因此两种式子都不能证明实盘费用。
8.3 三种中性的蕴含方向与几何投影失效算例
完整例题:中性约束与独立约束行
输入 :
4 资产持仓向量 w = ( 0.5 , 0.3 , − 0.4 , − 0.4 ) ⊤ \mathbf{w} = (0.5, 0.3, -0.4, -0.4)^\top w = ( 0.5 , 0.3 , − 0.4 , − 0.4 ) ⊤ β = ( 1.2 , 0.8 , 1.0 , 0.6 ) ⊤ \boldsymbol{\beta} = (1.2, 0.8, 1.0, 0.6)^\top β = ( 1.2 , 0.8 , 1.0 , 0.6 ) ⊤ [ A , B , A , B ] [A, B, A, B] [ A , B , A , B ] 手算核对 :
净资金暴露:0.5 + 0.3 − 0.4 − 0.4 = 0.0 0.5 + 0.3 - 0.4 - 0.4 = 0.0 0.5 + 0.3 − 0.4 − 0.4 = 0.0
总暴露:∣ 0.5 ∣ + ∣ 0.3 ∣ + ∣ − 0.4 ∣ + ∣ − 0.4 ∣ = 1.6 |0.5| + |0.3| + |-0.4| + |-0.4| = 1.6 ∣0.5∣ + ∣0.3∣ + ∣ − 0.4∣ + ∣ − 0.4∣ = 1.6 160 % 160\% 160%
Beta 暴露:0.5 ( 1.2 ) + 0.3 ( 0.8 ) − 0.4 ( 1.0 ) − 0.4 ( 0.6 ) = 0.60 + 0.24 − 0.40 − 0.24 = 0.20 ≠ 0 0.5(1.2) + 0.3(0.8) - 0.4(1.0) - 0.4(0.6) = 0.60 + 0.24 - 0.40 - 0.24 = 0.20 \ne 0 0.5 ( 1.2 ) + 0.3 ( 0.8 ) − 0.4 ( 1.0 ) − 0.4 ( 0.6 ) = 0.60 + 0.24 − 0.40 − 0.24 = 0.20 = 0
行业净暴露:
行业 A(资产 1 与 3):0.5 + ( − 0.4 ) = + 0.10 ≠ 0 0.5 + (-0.4) = +0.10 \ne 0 0.5 + ( − 0.4 ) = + 0.10 = 0 0.3 + ( − 0.4 ) = − 0.10 ≠ 0 0.3 + (-0.4) = -0.10 \ne 0 0.3 + ( − 0.4 ) = − 0.10 = 0 A A A v = w − A ⊤ ( A A ⊤ ) − 1 A w \mathbf{v} = \mathbf{w} - A^\top(AA^\top)^{-1}A\mathbf{w} v = w − A ⊤ ( A A ⊤ ) − 1 A w A = [ 1 ⊤ ; β ⊤ ; Z A ] A=[\mathbf1^\top;\boldsymbol\beta^\top;Z_A] A = [ 1 ⊤ ; β ⊤ ; Z A ] Z A = ( 1 , 0 , 1 , 0 ) Z_A=(1,0,1,0) Z A = ( 1 , 0 , 1 , 0 ) Z B = ( 0 , 1 , 0 , 1 ) Z_B=(0,1,0,1) Z B = ( 0 , 1 , 0 , 1 ) 1 ⊤ = Z A + Z B \mathbf1^\top=Z_A+Z_B 1 ⊤ = Z A + Z B A A ⊤ AA^\top A A ⊤
v ∗ = ( 0.05 , − 0.05 , − 0.05 , 0.05 ) ⊤ .
\mathbf{v}^* = (0.05, -0.05, -0.05, 0.05)^\top.
v ∗ = ( 0.05 , − 0.05 , − 0.05 , 0.05 ) ⊤ . 总暴露从 1.6 1.6 1.6 0.20 0.20 0.20 87.5 % 87.5\% 87.5%
8.4 Maillard–Roncalli–Teiletche(2009)四资产风险预算算例
完整例题:四资产风险预算
输入 :
4 个资产的年化波动率向量为 σ = [ 0.10 , 0.20 , 0.30 , 0.40 ] ⊤ \boldsymbol{\sigma} = [0.10, 0.20, 0.30, 0.40]^\top σ = [ 0.10 , 0.20 , 0.30 , 0.40 ] ⊤
C = [ 1.0 0.8 0.0 0.0 0.8 1.0 0.0 0.0 0.0 0.0 1.0 − 0.5 0.0 0.0 − 0.5 1.0 ] .
C = \begin{bmatrix} 1.0 & 0.8 & 0.0 & 0.0 \\ 0.8 & 1.0 & 0.0 & 0.0 \\ 0.0 & 0.0 & 1.0 & -0.5 \\ 0.0 & 0.0 & -0.5 & 1.0 \end{bmatrix}.
C = 1.0 0.8 0.0 0.0 0.8 1.0 0.0 0.0 0.0 0.0 1.0 − 0.5 0.0 0.0 − 0.5 1.0 . 协方差矩阵为 Σ = diag ( σ ) C diag ( σ ) \Sigma = \operatorname{diag}(\boldsymbol{\sigma}) C \operatorname{diag}(\boldsymbol{\sigma}) Σ = diag ( σ ) C diag ( σ ) 计算结果与特征 :
等权组合(1/N, w = [ 0.25 , 0.25 , 0.25 , 0.25 ] ⊤ \mathbf{w} = [0.25, 0.25, 0.25, 0.25]^\top w = [ 0.25 , 0.25 , 0.25 , 0.25 ] ⊤ :
组合总波动率:σ = 11.51 % \sigma = 11.51\% σ = 11.51% 0.115109 0.115109 0.115109
边际风险贡献:MRC = [ 0.0565 , 0.1216 , 0.0652 , 0.2172 ] ⊤ \operatorname{MRC} = [0.0565, 0.1216, 0.0652, 0.2172]^\top MRC = [ 0.0565 , 0.1216 , 0.0652 , 0.2172 ] ⊤
相对风险份额:p = [ 12.26 % , 26.42 % , 14.15 % , 47.17 % ] ⊤ p = [12.26\%, 26.42\%, 14.15\%, 47.17\%]^\top p = [ 12.26% , 26.42% , 14.15% , 47.17% ] ⊤ 47.17 % 47.17\% 47.17%
长仓最小方差组合(Long-Only Min Var) :
权重向量:w = [ 74.48 % , 0.00 % , 15.17 % , 10.34 % ] ⊤ \mathbf{w} = [74.48\%, 0.00\%, 15.17\%, 10.34\%]^\top w = [ 74.48% , 0.00% , 15.17% , 10.34% ] ⊤
组合总波动率:σ = 8.63 % \sigma = 8.63\% σ = 8.63% 0.086303 0.086303 0.086303
相对风险份额:严格等于权重比例 [ 74.48 % , 0.00 % , 15.17 % , 10.34 % ] ⊤ [74.48\%, 0.00\%, 15.17\%, 10.34\%]^\top [ 74.48% , 0.00% , 15.17% , 10.34% ] ⊤ 0.086303 0.086303 0.086303 0.138085 0.138085 0.138085
等风险贡献组合(ERC) :
权重向量:w = [ 38.36 % , 19.18 % , 24.26 % , 18.20 % ] ⊤ \mathbf{w} = [38.36\%, 19.18\%, 24.26\%, 18.20\%]^\top w = [ 38.36% , 19.18% , 24.26% , 18.20% ] ⊤
组合总波动率:σ = 10.29 % \sigma = 10.29\% σ = 10.29% 0.102934 0.102934 0.102934
相对风险份额:严格实现每资产恰为 25.00 % 25.00\% 25.00% p = [ 0.25 , 0.25 , 0.25 , 0.25 ] ⊤ p = [0.25, 0.25, 0.25, 0.25]^\top p = [ 0.25 , 0.25 , 0.25 , 0.25 ] ⊤
单调性定理验证 :
σ m v ( 8.63 % ) ≤ σ e r c ( 10.29 % ) ≤ σ 1 / n ( 11.51 % ) .
\sigma_{mv} (8.63\%) \le \sigma_{erc} (10.29\%) \le \sigma_{1/n} (11.51\%).
σ m v ( 8.63% ) ≤ σ er c ( 10.29% ) ≤ σ 1/ n ( 11.51% ) . 严格遵循 Maillard et al.(2009)的数学排序定理。
8.5 Black–Litterman 两资产手算例
完整例题:观点更新与无约束持仓
输入 :
两资产协方差矩阵(年化):Σ = [ 0.04 0.02 0.02 0.09 ] \Sigma = \begin{bmatrix} 0.04 & 0.02 \\ 0.02 & 0.09 \end{bmatrix} Σ = [ 0.04 0.02 0.02 0.09 ] w m k t = ( 0.60 , 0.40 ) ⊤ \mathbf{w}_{mkt} = (0.60, 0.40)^\top w mk t = ( 0.60 , 0.40 ) ⊤ δ = 2.5 \delta = 2.5 δ = 2.5 τ = 0.05 \tau = 0.05 τ = 0.05 10.0 % 10.0\% 10.0% 0.10 0.10 0.10 P = [ 1.0 , 0.0 ] P = [1.0, 0.0] P = [ 1.0 , 0.0 ] Q = [ 0.10 ] Q = [0.10] Q = [ 0.10 ] Ω = τ P Σ P ⊤ = 0.05 ( 0.04 ) = 0.002 \Omega = \tau P \Sigma P^\top = 0.05(0.04) = 0.002 Ω = τ P Σ P ⊤ = 0.05 ( 0.04 ) = 0.002 手算步骤 :
反向优化求均衡收益 Π = δ Σ w m k t \boldsymbol{\Pi} = \delta \Sigma \mathbf{w}_{mkt} Π = δ Σ w mk t :
Σ w m k t = [ 0.04 ( 0.6 ) + 0.02 ( 0.4 ) 0.02 ( 0.6 ) + 0.09 ( 0.4 ) ] = [ 0.024 + 0.008 0.012 + 0.036 ] = [ 0.032 0.048 ] .
\Sigma \mathbf{w}_{mkt} = \begin{bmatrix} 0.04(0.6) + 0.02(0.4) \\ 0.02(0.6) + 0.09(0.4) \end{bmatrix} = \begin{bmatrix} 0.024 + 0.008 \\ 0.012 + 0.036 \end{bmatrix} = \begin{bmatrix} 0.032 \\ 0.048 \end{bmatrix}.
Σ w mk t = [ 0.04 ( 0.6 ) + 0.02 ( 0.4 ) 0.02 ( 0.6 ) + 0.09 ( 0.4 ) ] = [ 0.024 + 0.008 0.012 + 0.036 ] = [ 0.032 0.048 ] . 乘上 δ = 2.5 \delta = 2.5 δ = 2.5
Π = 2.5 [ 0.032 0.048 ] = [ 0.08 0.12 ] ( 资产 1 均衡年化 8.0%, 资产 2 均衡年化 12.0% ) .
\boldsymbol{\Pi} = 2.5 \begin{bmatrix} 0.032 \\ 0.048 \end{bmatrix} = \begin{bmatrix} 0.08 \\ 0.12 \end{bmatrix} \quad (\text{资产 1 均衡年化 8.0\%, 资产 2 均衡年化 12.0\%}).
Π = 2.5 [ 0.032 0.048 ] = [ 0.08 0.12 ] ( 资产 1 均衡年化 8.0%, 资产 2 均衡年化 12.0% ) .
中间项与增益矩阵计算 :
P τ Σ P ⊤ + Ω = 0.05 ( 0.04 ) + 0.002 = 0.002 + 0.002 = 0.004.
P \tau \Sigma P^\top + \Omega = 0.05(0.04) + 0.002 = 0.002 + 0.002 = 0.004.
P τ Σ P ⊤ + Ω = 0.05 ( 0.04 ) + 0.002 = 0.002 + 0.002 = 0.004. 增益向量:
M = τ Σ P ⊤ ( 0.004 ) − 1 = 0.05 [ 0.04 0.02 ] 1 0.004 = [ 0.002 0.001 ] × 250 = [ 0.50 0.25 ] .
M = \tau \Sigma P^\top (0.004)^{-1} = 0.05 \begin{bmatrix} 0.04 \\ 0.02 \end{bmatrix} \frac{1}{0.004} = \begin{bmatrix} 0.002 \\ 0.001 \end{bmatrix} \times 250 = \begin{bmatrix} 0.50 \\ 0.25 \end{bmatrix}.
M = τ Σ P ⊤ ( 0.004 ) − 1 = 0.05 [ 0.04 0.02 ] 0.004 1 = [ 0.002 0.001 ] × 250 = [ 0.50 0.25 ] .
后验期望收益率均值 :
观点超额:Q − P Π = 0.10 − 0.08 = 0.02 Q - P\boldsymbol{\Pi} = 0.10 - 0.08 = 0.02 Q − P Π = 0.10 − 0.08 = 0.02
μ B L = [ 0.08 0.12 ] + [ 0.50 0.25 ] ( 0.02 ) = [ 0.08 + 0.010 0.12 + 0.005 ] = [ 0.090 0.125 ] ( 9.0 % , 12.5 % ) .
\boldsymbol{\mu}_{BL} = \begin{bmatrix} 0.08 \\ 0.12 \end{bmatrix} + \begin{bmatrix} 0.50 \\ 0.25 \end{bmatrix} (0.02) = \begin{bmatrix} 0.08 + 0.010 \\ 0.12 + 0.005 \end{bmatrix} = \begin{bmatrix} 0.090 \\ 0.125 \end{bmatrix} \quad (9.0\%, 12.5\%).
μ B L = [ 0.08 0.12 ] + [ 0.50 0.25 ] ( 0.02 ) = [ 0.08 + 0.010 0.12 + 0.005 ] = [ 0.090 0.125 ] ( 9.0% , 12.5% ) .
后验均值协方差矩阵 :
V B L = τ Σ − M P τ Σ = [ 0.002 0.001 0.001 0.0045 ] − [ 0.50 0.25 ] [ 0.002 , 0.001 ] = [ 0.0010 0.0005 0.0005 0.00425 ] .
V_{BL} = \tau \Sigma - M P \tau \Sigma = \begin{bmatrix} 0.002 & 0.001 \\ 0.001 & 0.0045 \end{bmatrix} - \begin{bmatrix} 0.50 \\ 0.25 \end{bmatrix} [0.002, 0.001] = \begin{bmatrix} 0.0010 & 0.0005 \\ 0.0005 & 0.00425 \end{bmatrix}.
V B L = τ Σ − M P τ Σ = [ 0.002 0.001 0.001 0.0045 ] − [ 0.50 0.25 ] [ 0.002 , 0.001 ] = [ 0.0010 0.0005 0.0005 0.00425 ] .
最优无约束权重 w ∗ = ( δ Σ ) − 1 μ B L \mathbf{w}^* = (\delta \Sigma)^{-1}\boldsymbol{\mu}_{BL} w ∗ = ( δ Σ ) − 1 μ B L :
δ Σ = 2.5 [ 0.04 0.02 0.02 0.09 ] = [ 0.10 0.05 0.05 0.225 ] .
\delta \Sigma = 2.5 \begin{bmatrix} 0.04 & 0.02 \\ 0.02 & 0.09 \end{bmatrix} = \begin{bmatrix} 0.10 & 0.05 \\ 0.05 & 0.225 \end{bmatrix}.
δ Σ = 2.5 [ 0.04 0.02 0.02 0.09 ] = [ 0.10 0.05 0.05 0.225 ] . 行列式 det = 0.10 ( 0.225 ) − 0.05 2 = 0.0225 − 0.0025 = 0.020 \det = 0.10(0.225) - 0.05^2 = 0.0225 - 0.0025 = 0.020 det = 0.10 ( 0.225 ) − 0.0 5 2 = 0.0225 − 0.0025 = 0.020
( δ Σ ) − 1 = 1 0.020 [ 0.225 − 0.05 − 0.05 0.10 ] = [ 11.25 − 2.50 − 2.50 5.00 ] .
(\delta \Sigma)^{-1} = \frac{1}{0.020}\begin{bmatrix} 0.225 & -0.05 \\ -0.05 & 0.10 \end{bmatrix} = \begin{bmatrix} 11.25 & -2.50 \\ -2.50 & 5.00 \end{bmatrix}.
( δ Σ ) − 1 = 0.020 1 [ 0.225 − 0.05 − 0.05 0.10 ] = [ 11.25 − 2.50 − 2.50 5.00 ] . 计算权重:
w ∗ = [ 11.25 ( 0.090 ) − 2.50 ( 0.125 ) − 2.50 ( 0.090 ) + 5.00 ( 0.125 ) ] = [ 1.0125 − 0.3125 − 0.225 + 0.625 ] = [ 0.70 0.40 ] .
\mathbf{w}^* = \begin{bmatrix} 11.25(0.090) - 2.50(0.125) \\ -2.50(0.090) + 5.00(0.125) \end{bmatrix} = \begin{bmatrix} 1.0125 - 0.3125 \\ -0.225 + 0.625 \end{bmatrix} = \begin{bmatrix} 0.70 \\ 0.40 \end{bmatrix}.
w ∗ = [ 11.25 ( 0.090 ) − 2.50 ( 0.125 ) − 2.50 ( 0.090 ) + 5.00 ( 0.125 ) ] = [ 1.0125 − 0.3125 − 0.225 + 0.625 ] = [ 0.70 0.40 ] . 关键洞察 :
资产 2 并没有被直接施加观点,但由于它与资产 1 存在正协方差(0.02 0.02 0.02 12.0 % 12.0\% 12.0% 12.5 % 12.5\% 12.5% 0.40 0.40 0.40 + 0.10 +0.10 + 0.10 0.60 0.60 0.60 0.70 0.70 0.70
这组无约束风险资产权重合计1.10,现金权重为−0.10,即借入净值的10%。若不允许融资,应重新求解带预算约束的问题,不能机械归一化后仍称同一最优解。
Black–Litterman 观点置信度与权重演化曲线
横轴 :观点方差缩放乘数 Ω / ( τ P Σ P ⊤ ) \Omega / (\tau P \Sigma P^\top) Ω/ ( τ P Σ P ⊤ ) 纵轴 :左图为后验期望收益率(年化 % \% % % \% % 单位 :百分比(% \% % 读法与观察点 :
左图中,当置信度极高(横轴最左端)时,资产 1 的后验期望收益逼近主观观点 10.0 % 10.0\% 10.0% 13.0 % 13.0\% 13.0% 8.0 % 8.0\% 8.0% 12.0 % 12.0\% 12.0%
右图中,无论观点置信度如何变化,未施加观点的资产 2 其最优权重恒定在 40.0 % 40.0\% 40.0% 80 % 80\% 80% 60 % 60\% 60%
局限性 :此为两资产教学构造模型,未考虑带有多重非正交观点及带约束二次规划时的交互效应。
9. Python 实现与测试验证
默认独立运行入口
在随书读者包根目录,按包内环境说明建立独立环境后运行:
.venv/bin/python run_notebook.py notebooks/ch21_portfolio_construction.ipynb
默认 RUN_FRENCH=False。Notebook依次核对LW收缩、MRT四资产风险、BL、Kelly、中性约束与漂移,并检查有限Sharpe、ERC存在性、均值后验协方差与二次增长代理等边界。它只创建章节 RUN_DIR,不写CSV或PNG,跳过历史图库;第3、5.4、6.5、8.5和11节图像是已有读物,不能当作本次运行产物。章运行目录与运行器另建的 runs/execution_ch21_portfolio_construction_<uuid>/ 不同,后者保存执行副本与状态。
本章21-E08用月度超额均值0.008、方差0.0025,二次代理权重为3.2;Notebook另用0.006和0.0016,权重为3.75,是不同构造输入。精确二项半Kelly增长比约74.9268%;二次增长代理在其自身最优风险权重的一半处给出75%,不能把该比例当作精确二项增长的一般结论。中性约束按本章第5.2节判断:互斥且穷尽的绝对行业中性推出美元中性,一般不能推出Beta中性。
Project 3的独立入口、构造输出与历史报告分别见项目导读 。下方展示共享实现的调用与断言;课程工作根需已安装课程包及其依赖,不能把一个未配置环境的裸Python解释器视作完整读者入口。
共享实现调用
以下代码展示了核心模块 src/quant_course/portfolio_construction.py 的调用方法,并用断言复核第8.1–8.3及8.5节;第8.4节ERC四资产例的完整代码在21-P01答案中。代码需要课程包及相应依赖。
import numpy as np
from quant_course.portfolio_construction import (
ledoit_wolf_identity, risk_contributions, risk_budget_weights,
max_sharpe_long_only, black_litterman, he_litterman_view_covariance,
kelly_binary_fraction, binary_log_growth, gaussian_kelly_weights,
quadratic_log_growth, exposure_report, project_to_constraints,
drift_weights, turnover,
)
x_hand = np.array([[3.0 , 2.0 ], [-1.0 , -2.0 ], [2.0 , 3.0 ], [-4.0 , -3.0 ]])
lw_res = ledoit_wolf_identity(x_hand)
assert np.isclose(lw_res.target_scale, 7.0 )
assert np.isclose(lw_res.intensity, 8.0 / 42.5 )
np.testing.assert_allclose(lw_res.sample_covariance, [[7.5 , 6.5 ], [6.5 , 6.5 ]], atol=1e-12 )
np.testing.assert_allclose(
lw_res.covariance,
[[7.40588235 , 5.27647059 ], [5.27647059 , 6.59411765 ]],
atol=1e-6 ,
)
cov_bl = np.array([[0.04 , 0.02 ], [0.02 , 0.09 ]])
w_mkt = np.array([0.6 , 0.4 ])
p_view = np.array([[1.0 , 0.0 ]])
q_view = np.array([0.10 ])
tau_param = 0.05
omega_view = he_litterman_view_covariance(p_view, cov_bl, tau=tau_param)
bl_res = black_litterman(
cov_bl, w_mkt, risk_aversion=2.5 , tau=tau_param,
view_matrix=p_view, view_returns=q_view, view_covariance=omega_view,
)
np.testing.assert_allclose(bl_res.equilibrium_returns, [0.08 , 0.12 ], atol=1e-12 )
np.testing.assert_allclose(bl_res.posterior_mean, [0.09 , 0.125 ], atol=1e-12 )
np.testing.assert_allclose(bl_res.weights, [0.7 , 0.4 ], atol=1e-12 )
f_star = kelly_binary_fraction(0.55 , 1.0 )
assert np.isclose(f_star, 0.10 )
g_full = binary_log_growth(0.10 , 0.55 , 1.0 )
g_half = binary_log_growth(0.05 , 0.55 , 1.0 )
g_double = binary_log_growth(0.20 , 0.55 , 1.0 )
assert np.isclose(g_full, 0.0050083668 , atol=1e-6 )
assert np.isclose(g_half, 0.0037526078 , atol=1e-6 )
assert g_double < 0
w_demo = np.array([0.5 , 0.3 , -0.4 , -0.4 ])
beta_demo = np.array([1.2 , 0.8 , 1.0 , 0.6 ])
sectors_demo = ["A" , "B" , "A" , "B" ]
rep = exposure_report(w_demo, beta_demo, sectors_demo)
assert np.isclose(rep.net, 0.0 )
assert np.isclose(rep.beta, 0.2 )
a_mat = np.vstack([np.ones(4 ), beta_demo, [1.0 , 0.0 , 1.0 , 0.0 ]])
proj_w = project_to_constraints(w_demo, a_mat)
np.testing.assert_allclose(a_mat @ proj_w, 0.0 , atol=1e-12 )
w_init = np.array([0.5 , 0.5 ])
r_month = np.array([0.10 , -0.10 ])
w_drift = drift_weights(w_init, r_month)
np.testing.assert_allclose(w_drift, [0.55 , 0.45 ], atol=1e-12 )
turnover_val = turnover(w_drift, w_init)
assert np.isclose(turnover_val, 0.10 , atol=1e-12 )
10. 可视化分析(Visualization)
本节对预先生成的 4 幅核心图表展开多维分析。所有图像均从固定种子与冻结数据生成。
图已随讲解就近放置:第3节估计误差模拟,第6.5节Kelly增长,第8.5节BL观点置信度,第11节French行业风险份额。四图原有输入、轴、单位与局限性均保留;第5.4节的新增两资产图用于区分资金份额与风险份额。
11. 真实市场实证(Real Market Example)
实证采用 Kenneth R. French Data Library 冻结快照数据:
资产集合:美股 10 行业市值加权月度收益率(NoDur, Durbl, Manuf, Enrgy, HiTec, Telcm, Shops, Hlth, Utils, Other)及 Fama–French 三因子无风险利率(RF);
样本覆盖期:1926-07 至 2026-08(共 1,202 个日历月);
原始文件哈希:industry_raw_zip SHA-256 为 ebd937a4b995d821867aeb956a96f09a666386f38fa82516b7d1767ee4a49ae5;
数据性质声明:French 数据为当前学术修订版本,非实时点(Point-in-Time, PIT)历史快照。月度数据发布有滞后,历史值可能修订,本地 manifest 未保存历史版本。滞后 0 个月的设定属于理想化月边界决策测试。
在 2010-01 至 2019-12 的 120 个月区间内,基于 Ledoit–Wolf 协方差估计量,四种典型策略的具体实测表现记录于 outputs/ch21/ch21_results.json:
策略组合
月度波动率
最大权重行业与比例
最小权重行业与比例
风险分散特征
等权组合(1/N) 3.51%
各行业均匀 10.0%
各行业均匀 10.0%
风险份额失衡(Durbl 15.1% vs Utils 4.5%)
长仓最小方差 2.73%
Utils (47.45%), NoDur (23.31%)
Durbl, Manuf, Enrgy, HiTec (0.0%)
极度集中于低波动防御资产,6个行业权重为0
长仓最大 Sharpe 2.88%
Utils (36.08%), Shops (27.40%)
NoDur, Durbl, Manuf, Enrgy, Other (0.0%)
追逐高历史收益资产,5个行业权重为0
等风险贡献(ERC) 3.24%
Utils (17.62%), NoDur (12.42%)
Durbl (6.41%), Enrgy (7.32%)
全部行业非零配置,风险份额严格保持10.0%
数据表明,长仓最小方差组合虽然波动率最低,但付出了持仓极度集中的代价(前两大行业占比超 70 % 70\% 70%
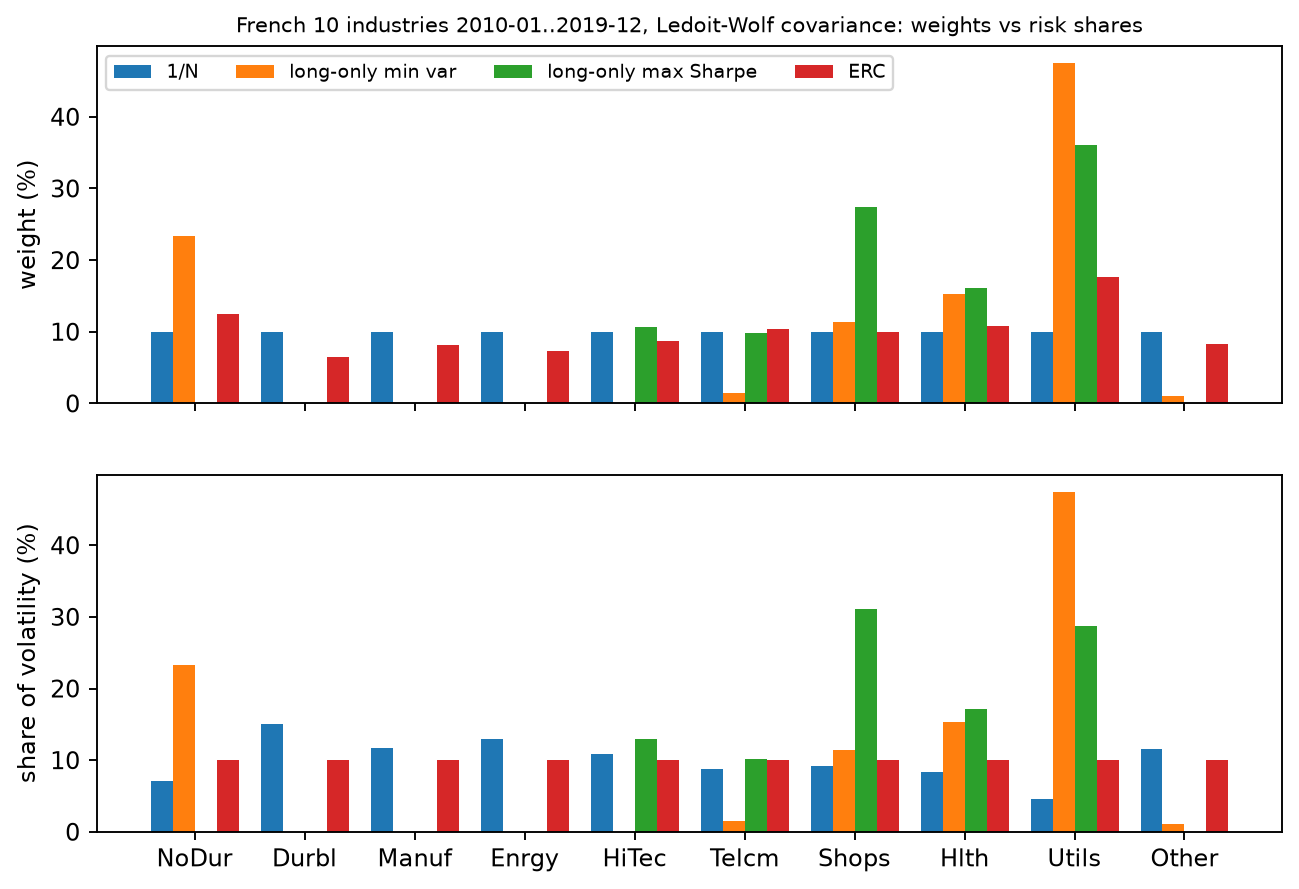
French 10 行业历史窗口风险分解面板
横轴 :French 10 行业代码(NoDur, Durbl, Manuf, Enrgy, HiTec, Telcm, Shops, Hlth, Utils, Other);纵轴 :上图为名义持仓权重百分比(% \% % % \% % 单位 :百分比(% \% % 样本 :2010-01 至 2019-12(共 120 个月),基于 Ledoit–Wolf 收缩协方差矩阵;读法与观察点 :
在等权组合(1/N)中,虽然每个行业权重严格为 10.0 % 10.0\% 10.0% 4.52 % 4.52\% 4.52% 15.09 % 15.09\% 15.09% 12.97 % 12.97\% 12.97%
长仓最小方差组合(long-only min var)将权重高度集中在防御型行业(Utils 47.45 % 47.45\% 47.45% 23.31 % 23.31\% 23.31% 15.27 % 15.27\% 15.27%
ERC 组合在下图中各行业风险份额均为 10.0 % 10.0\% 10.0% 17.62 % 17.62\% 17.62% 6.41 % 6.41\% 6.41%
月度波动率对比:最小方差(2.73 % 2.73\% 2.73% 2.88 % 2.88\% 2.88% 3.24 % 3.24\% 3.24% 3.51 % 3.51\% 3.51%
局限性 :本图仅展示 2010–2019 单一历史窗口的事后静态截面描述,不构成滚动样本外的实盘策略结论。
12. 常见错误与调试(Common Mistakes)
在量化组合构建的工程实践中,由于浮点精度、求解器内部实现与金融约束的复杂交互,研究员常遇到以下典型陷阱:
12.1 协方差矩阵数值尺度过小导致求解器虚假超差
错误现象 :在计算长仓最小方差组合时,直接将月度协方差矩阵(元素量级常在 10 − 3 ∼ 10 − 4 10^{-3} \sim 10^{-4} 1 0 − 3 ∼ 1 0 − 4 optimal,但在独立核算原始约束时,预算约束残差 ∣ ∑ w i − 1 ∣ |\sum w_i - 1| ∣ ∑ w i − 1∣ 10 − 6 10^{-6} 1 0 − 6 可能原因 :求解器的停止准则依赖与问题尺度相关的残差和对偶间隙容差;二次项系数很小时,目标对权重偏离不敏感,求解器可能在预算残差尚未达到 10 − 6 10^{-6} 1 0 − 6 修复方案 :在进入均值方差求解器前,将协方差矩阵除以其最大绝对值进行谱尺度归一化:Σ ~ = Σ / max i , j ∣ Σ i j ∣ \tilde{\Sigma} = \Sigma / \max_{i,j}|\Sigma_{ij}| Σ ~ = Σ/ max i , j ∣ Σ ij ∣ w ∗ \mathbf{w}^* w ∗ O ( 1 ) O(1) O ( 1 )
12.2 阻尼 Newton 法对数障碍迭代中的伪收敛停滞
错误现象 :在求解等风险贡献(ERC)对数障碍目标时,将线搜索容差设定在浮点机器精度极限(如 10 − 12 10^{-12} 1 0 − 12 原因机理 :当目标函数值处于 O ( 1 ) O(1) O ( 1 ) 10 − 16 10^{-16} 1 0 − 16 修复方案 :遵循 Boyd & Vandenberghe(2004)§9.5 规范,采用 Newton 减量 λ 2 = − ∇ f ( y ) ⊤ Δ y ≤ 10 − 14 \lambda^2 = -\nabla f(\mathbf{y})^\top \Delta \mathbf{y} \le 10^{-14} λ 2 = − ∇ f ( y ) ⊤ Δ y ≤ 1 0 − 14 max i ∣ p i − b i ∣ ≤ 10 − 6 \max_i |p_i - b_i| \le 10^{-6} max i ∣ p i − b i ∣ ≤ 1 0 − 6
12.3 最大 Sharpe 比率优化存在权重上限时的可行性漏检
错误现象 :仅检查“是否存在正超额收益资产”,如果存在就直接构造凸 QP 并调用求解器。当存在单资产上限(如 w max = 0.4 w_{\max} = 0.4 w m a x = 0.4 infeasible。原因机理 :单资产存在正超额收益并不意味着单纯形可行域内存在正超额组合。若唯一正超额资产被上限截断在 40 % 40\% 40% 60 % 60\% 60% 修复方案 :在进入 QP 之前,按超额收益降序进行贪心填充(greedy fill),计算受限单纯形上的理论最大超额收益。若最大收益非正,提前抛出可解释的 OptimizationError。
以下代码演示了尺度归一化修复与上限可行性预检的独立验证:
import numpy as np
from quant_course.optimization_tools import OptimizationError, solve_mean_variance
from quant_course.portfolio_construction import max_sharpe_long_only
cov_tiny = np.array([[0.0004 , 0.0001 ], [0.0001 , 0.0009 ]])
cov_scaled = cov_tiny / float (np.max (np.abs (cov_tiny)))
res_scaled = solve_mean_variance(np.zeros(2 ), cov_scaled)
np.testing.assert_allclose(res_scaled.weights, [8 / 11 , 3 / 11 ], atol=1e-6 )
mu_infeasible = np.array([0.004 , -0.004 , -0.004 ])
cov_diag = np.diag([0.01 , 0.01 , 0.01 ])
try :
max_sharpe_long_only(
mu_infeasible, cov_diag, risk_free_return=0.0 , max_weight=0.4 ,
)
except OptimizationError as exc:
assert exc.solver_status == "infeasible_by_inputs"
13. 量化研究实战:Project 3 滚动样本外评测
作为量化投资组合构建的综合工程检验,项目 projects/project03/src/project03_backtest.py 构建了覆盖 1990-01 至 2026-08(共 440 个评价月)的滚动样本外评测系统。
13.1 回测体系与参数基准
主回测规格(Primary Spec) :
训练窗口:W = 60 W = 60 W = 60
协方差估计量:Ledoit–Wolf 收缩(收缩至缩放单位阵);
约束条件:长仓投资(w i ≥ 0 w_i \ge 0 w i ≥ 0 w max = 40 % w_{\max} = 40\% w m a x = 40%
调仓时点与滞后:滞后 0 个月(在 t − 1 t-1 t − 1
交易成本基准:双边总换手乘以 10 bps 10\text{ bps} 10 bps c = 0.0010 c = 0.0010 c = 0.0010
对比策略集 :
equal_weight:每月等权 1/N(基准);min_variance:长仓带上限最小方差组合;max_sharpe:长仓带上限最大 Sharpe 比率组合;erc:等风险贡献组合。
13.2 评测结果与统计推断
基于 projects/project03/outputs/summary.json 与 sensitivity.csv,440 个月的核心业绩统计如下:
评估指标
等权组合(1/N)
最小方差(Min Var)
最大 Sharpe(Max Sharpe)
等风险贡献(ERC)
年化净超额收益 9.05%
7.03%
8.01%
8.66%
年化净波动率 14.32%
11.78%
14.36%
13.37%
年化净 Sharpe 比率 0.631
0.596
0.558
0.648
年化毛 Sharpe 比率 0.634
0.605
0.576
0.650
复合年均增长率 (CAGR) 11.25%
9.42%
10.11%
10.98%
最大回撤 (Max Drawdown) -48.09%
-36.41%
-41.49%
-45.52%
月均换手率 (Turnover) 2.58%
8.60%
21.45%
2.80%
年化平均费用占旧净值 3.36 bps
10.57 bps
25.96 bps
3.63 bps
年化平均毛净收益差 (Cost Drag) 3.37 bps
10.65 bps
26.20 bps
3.64 bps
平均有效资产数 (N e f f N_{eff} N e f f 10.00
4.03
3.49
9.31
失败触发回退次数 0
0
1
0
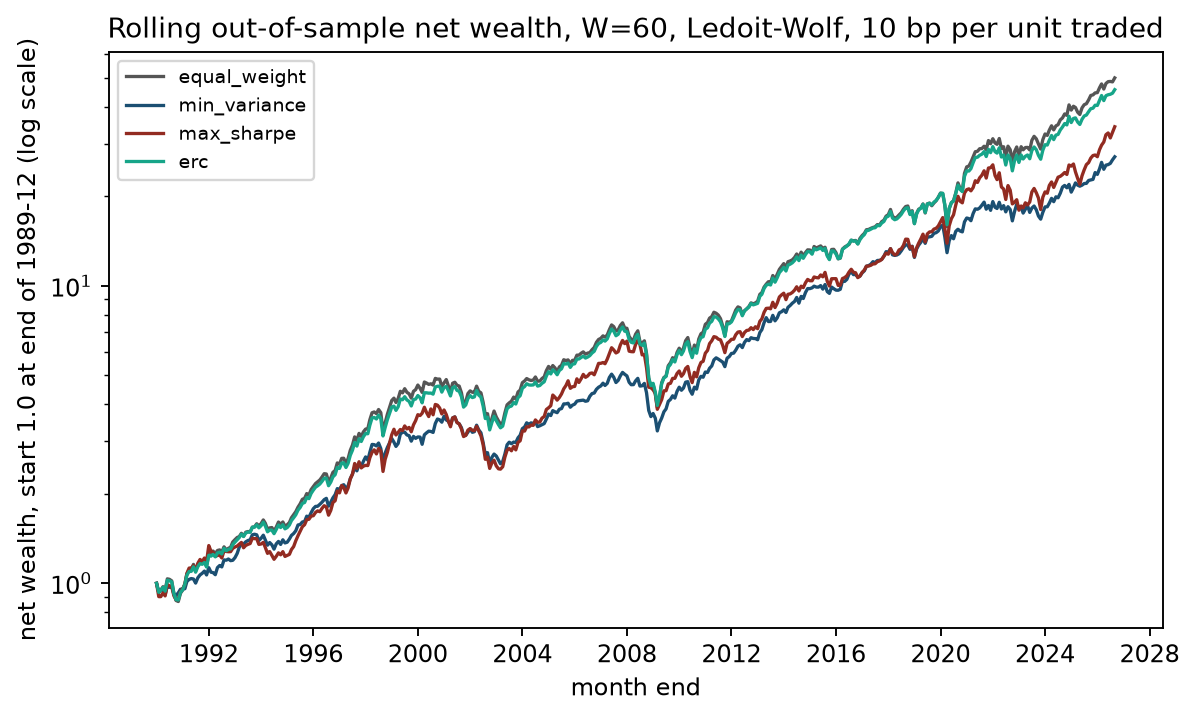
横轴 :回测月份(1990-01 至 2026-08);纵轴 :初始 1 元投资的累计财富净值(对数坐标);核心观察 :
没有任何优化策略在净收益上可信地击败 1/N 朴素等权。1/N 获得了最高的年化净超额收益(9.05 % 9.05\% 9.05%
最小方差组合在该样本中降低了全周期波动(11.78 % 11.78\% 11.78% 14.32 % 14.32\% 14.32% − 48.09 % -48.09\% − 48.09% − 36.41 % -36.41\% − 36.41%
最大 Sharpe 策略使用滚动样本均值、月均换手率为 21.45 % 21.45\% 21.45% 0.558 0.558 0.558
13.3 统计显著性推断(成对循环块 Bootstrap)
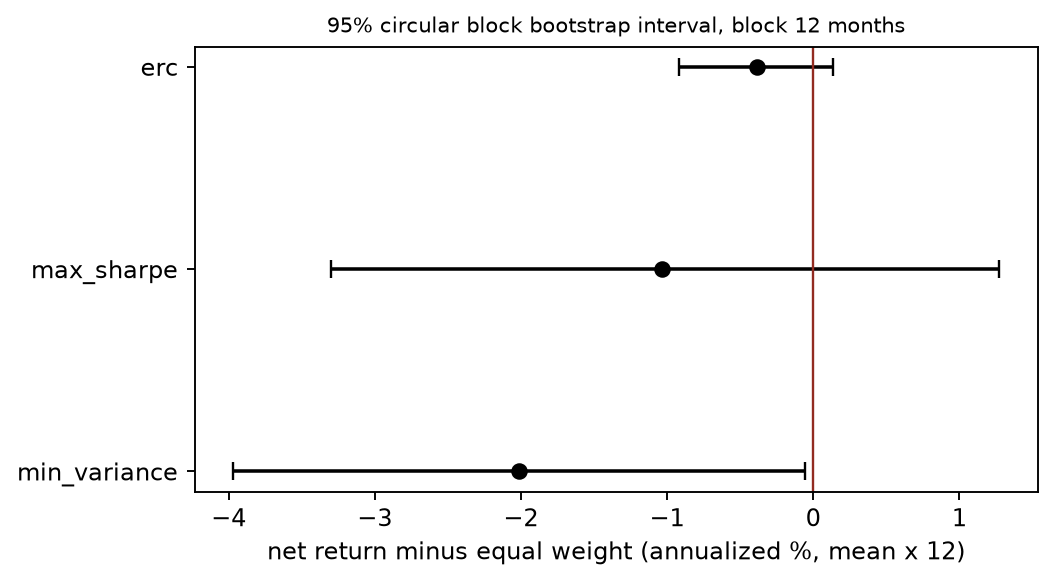
为评估策略收益与 Sharpe 差异是否具有统计显著性,Project 3 采用 5,000 次循环移动块自助法(circular moving-block bootstrap,块长 12 个月,种子 20261006);Sharpe 差采用成对重抽样:
最小方差 vs 等权 :月度平均收益差为 − 0.168 % -0.168\% − 0.168% 95 % 95\% 95% [ − 0.331 % , − 0.005 % ] [-0.331\%, -0.005\%] [ − 0.331% , − 0.005% ] 2.22 % 2.22\% 2.22% 未校正单项区间低于零 ;三策略×两指标未做多重比较校正,不能将其称为全家族显著性结论;最大 Sharpe vs 等权 :月度平均收益差为 − 0.086 % -0.086\% − 0.086% 95 % 95\% 95% [ − 0.275 % , + 0.106 % ] [-0.275\%, +0.106\%] [ − 0.275% , + 0.106% ] − 0.073 -0.073 − 0.073 95 % 95\% 95% [ − 0.236 , + 0.089 ] [-0.236, +0.089] [ − 0.236 , + 0.089 ] ERC vs 等权 :虽然 ERC 的净夏普比率(0.648 0.648 0.648 0.631 0.631 0.631 + 0.016 +0.016 + 0.016 95 % 95\% 95% [ − 0.014 , + 0.050 ] [-0.014, +0.050] [ − 0.014 , + 0.050 ]
横轴为相对等权的年化平均净收益差(百分点,月度均值差乘12的算术报告口径),纵轴列出三种策略。圆点是样本差额,横线是95%成对循环块自助区间;观察区间是否跨越竖直的零差线。这张图不画Sharpe差,也没有多重比较校正。
13.4 成本与窗口敏感性分析
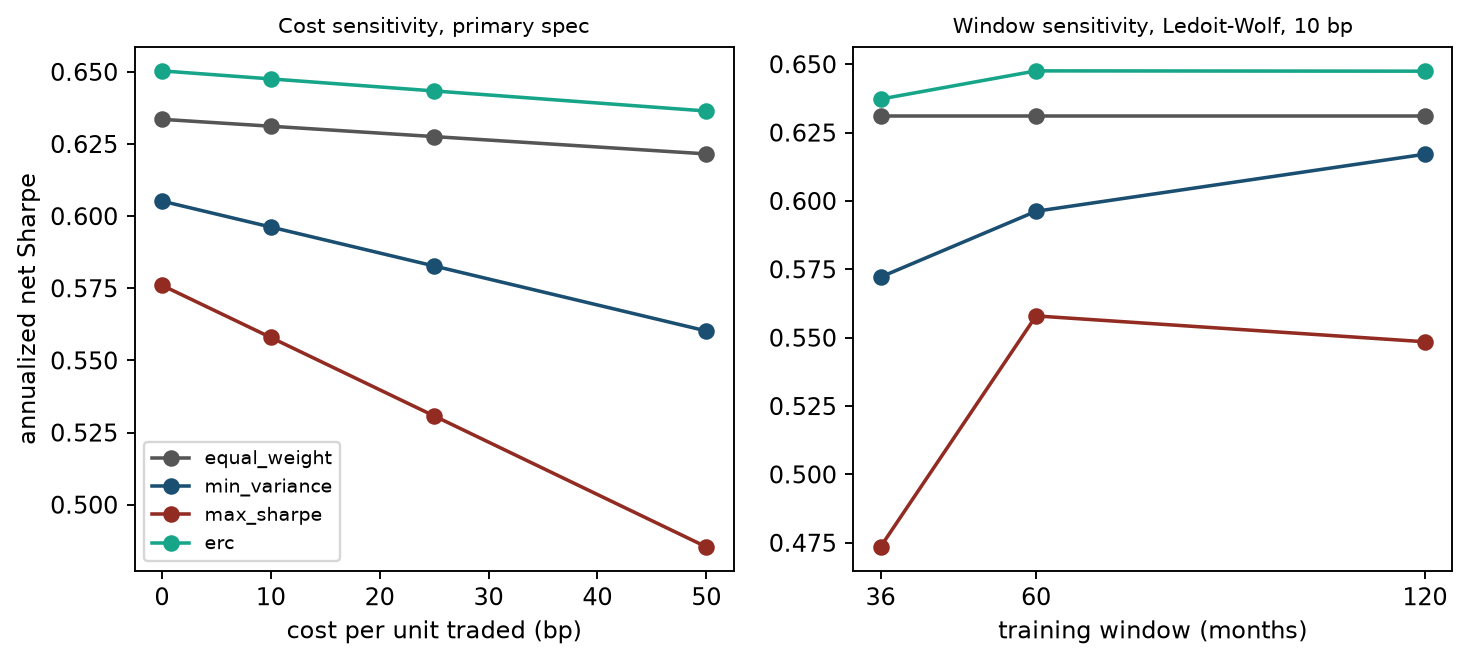
左图横轴为每单位买卖合计换手的成本(bp),右图横轴为训练窗长度(月),纵轴均为年化净Sharpe。比较各策略线的费用斜率与窗长变化,不用图中最高点反向挑参数。数据来自同一冻结样本下的预设敏感性规格,不能作为独立样本外检验。
成本敏感性 :当交易成本从 0 提高到 50 bps 时:
等权组合年化夏普比率仅从 0.634 0.634 0.634 0.622 0.622 0.622
ERC 从 0.650 0.650 0.650 0.636 0.636 0.636
最大 Sharpe 的年化净Sharpe从 0.576 0.576 0.576 0.485 0.485 0.485
窗口与滞后敏感性 :窗口缩短为 36 个月时,最大 Sharpe 在样本协方差和 Ledoit–Wolf 两种估计下都有 14 个月回退(8 个月所有行业训练窗超额均值为负,6 个月在 40% 上限下不存在正超额组合)。回退由均值估计引起,与协方差估计量无关;10 bp 下其净 Sharpe 降到 0.474。Ledoit–Wolf 对最小方差有小幅帮助(W60:0.596 对样本协方差 0.577)。滞后 1 个月几乎不改变结果(ERC 0.648 对 0.649)。
答案文件还提供W=24最大Sharpe净Sharpe约0.587、25次等权回退。该窗口在看到主结果后提出,属于事后探索(post hoc exploration),不在冻结12组窗口/协方差/滞后敏感性内,也不替换W=60主规格。探索可以生成下一次事先固定的新问题,不能增加本轮独立验证次数。
13.5 后见之明过拟合警示
用整个评价期(1990-01..2026-08)的样本矩、相同长仓与 40% 上限计算“后见之明(hindsight)”最大 Sharpe 组合(用到评价期信息,不可交易):
固定权重毛收益路径的月度实现Sharpe为 0.21774 0.21774 0.21774 0.75428 ,以同月超额收益的标准差为分母;给定矩求解器目标另为0.75386,分母是资产毛收益协方差,两者不可混称;
相比之下,滚动样本外的最大 Sharpe 实际年化夏普比率仅为 0.5580 。
同样零成本下滚动最大Sharpe为0.576,10bp代理费用下为0.558。全样本拟合使用评价期信息,同时估计窗和固定/滚动权重也不同;与滚动净口径的差不是单独识别的前视偏差因果效应,也不衡量可交易优势。
14. 本章小结与决策脉络(Chapter Summary)
估计误差主导风险 :期望收益的估计误差是均值方差优化的主要破坏因素。在缺乏可靠 Alpha 预测时,应采用收缩估计量控制协方差病态性,或退守至最小方差或风险平价组合。长仓与上限是天然的正则化手段 :长仓约束消除了做空杠杆发散,单资产上限阻止了单一极端头寸。带有这些约束的最大 Sharpe 问题可通过尺度变量代换精确化为凸二次规划(第 9 章已证)。中性概念不可混淆 :美元中性、Beta 中性与行业中性必须显式作为约束加入优化求解器。欧氏投影只优化权重距离,若目标包含风险和成本则需使用相应目标函数;全覆盖行业约束还会隐含美元约束,应删除冗余行。风险预算平衡真实的风险敞口 :等风险贡献(ERC)将风险均匀分配至各资产,避免高波动资产绑架组合。带 Newton 减量停止准则的阻尼 Newton 算法能高效稳定求解 ERC。交易成本决定实盘生死 :投资经理必须在调仓频率、跟踪误差与换手摩擦间权衡。高换手策略若无显著 Alpha 支持,净收益将在摩擦中耗尽。基准意识与证伪精神 :实盘优化策略必须以朴素等权(1/N)为第一基准。未经摩擦成本检验与 Bootstrap 显著性验证的优化优势,往往只是样本内的统计幻觉。
15. 概念与数学练习(Exercises)
21-E01(估计误差量纲) 沿用第5.1节IID与稳定方差假设,设某股票月度波动率为 6 % 6\% 6% % \% % 0.5 % 0.5\% 0.5% 95 % 95\% 95%
21-E02(Ledoit–Wolf 目标与强度) 简述 Ledoit–Wolf 收缩为何选择缩放单位阵 m I mI m I I I I κ ^ \hat{\kappa} κ ^ T → ∞ T \to \infty T → ∞
21-E03(漂移与换手计算) 组合包含三项资产,期初权重为 w = ( 0.4 , 0.4 , 0.2 ) \mathbf{w} = (0.4, 0.4, 0.2) w = ( 0.4 , 0.4 , 0.2 ) + 20 % +20\% + 20% − 10 % -10\% − 10% 0 % 0\% 0% w + \mathbf{w}^+ w +
21-E04(三种中性反例构造) 构造一个 3 资产投资组合的权重向量 w \mathbf{w} w β \boldsymbol{\beta} β 1 ⊤ w = 0 \mathbf{1}^\top \mathbf{w} = 0 1 ⊤ w = 0
21-E05(Euler 风险分解证明) 设对称半正定协方差下组合波动 σ ( w ) > 0 \sigma(\mathbf w)>0 σ ( w ) > 0 σ 2 ( w ) = w ⊤ Σ w \sigma^2(\mathbf{w}) = \mathbf{w}^\top \Sigma \mathbf{w} σ 2 ( w ) = w ⊤ Σ w ∂ σ ( w ) ∂ w i = ( Σ w ) i σ ( w ) \frac{\partial \sigma(\mathbf{w})}{\partial w_i} = \frac{(\Sigma \mathbf{w})_i}{\sigma(\mathbf{w})} ∂ w i ∂ σ ( w ) = σ ( w ) ( Σ w ) i ∑ i = 1 n w i MRC i = σ ( w ) \sum_{i=1}^n w_i \operatorname{MRC}_i = \sigma(\mathbf{w}) ∑ i = 1 n w i MRC i = σ ( w )
21-E06(两资产 ERC 解析推导) 设两资产波动率分别为 σ 1 , σ 2 \sigma_1, \sigma_2 σ 1 , σ 2 ρ ∈ ( − 1 , 1 ) \rho \in (-1, 1) ρ ∈ ( − 1 , 1 ) w 1 ( Σ w ) 1 = w 2 ( Σ w ) 2 w_1(\Sigma \mathbf{w})_1 = w_2(\Sigma \mathbf{w})_2 w 1 ( Σ w ) 1 = w 2 ( Σ w ) 2 w 1 = σ 2 σ 1 + σ 2 w_1 = \frac{\sigma_2}{\sigma_1 + \sigma_2} w 1 = σ 1 + σ 2 σ 2 ρ \rho ρ
21-E07(Black–Litterman 均衡收益反算) 设全市场包含两项资产,市场权重为 w m k t = ( 0.7 , 0.3 ) ⊤ \mathbf{w}_{mkt} = (0.7, 0.3)^\top w mk t = ( 0.7 , 0.3 ) ⊤ Σ = [ 0.05 0.01 0.01 0.02 ] \Sigma = \begin{bmatrix} 0.05 & 0.01 \\ 0.01 & 0.02 \end{bmatrix} Σ = [ 0.05 0.01 0.01 0.02 ] δ = 3.0 \delta = 3.0 δ = 3.0 Π \boldsymbol{\Pi} Π
21-E08(Kelly 连续近似推导) 写出组合对数增长率的二阶泰勒展开式。设单资产超额收益为 μ − r f = 0.008 \mu - r_f = 0.008 μ − r f = 0.008 σ 2 = 0.0025 \sigma^2 = 0.0025 σ 2 = 0.0025
16. 编程练习(Programming Exercises)
21-P01(四资产 MRT 数值测试) 编写独立测试脚本,读取第 8.4 节 Maillard et al.(2009)四资产输入,分别调用 quant_course.portfolio_construction 与优化工具,计算等权、长仓最小方差与 ERC 的权重与风险份额,用 assert 核对波动率满足 σ m v ≤ σ e r c ≤ σ 1 / n \sigma_{mv} \le \sigma_{erc} \le \sigma_{1/n} σ m v ≤ σ er c ≤ σ 1/ n
21-P02(秩亏协方差收缩验证) 生成形状为 10 × 20 10 \times 20 10 × 20 T < p T < p T < p rank ≤ 10 \operatorname{rank} \le 10 rank ≤ 10
21-P03(长仓最大 Sharpe 上限预检测试) 构造 3 资产超额均值 μ e x c e s s \boldsymbol{\mu}_{excess} μ e x cess 0.01 I 3 0.01I_3 0.01 I 3 0.40 0.40 0.40
17. 挑战题(Challenge Problems)
21-C01(因子模型下的风险贡献解析分解)
设资产收益由一般多因子模型驱动,因子与特异项互不相关,但不要求各因子正交:r = B f + ε \mathbf{r} = B \mathbf{f} + \boldsymbol{\varepsilon} r = B f + ε Σ f \Sigma_f Σ f Σ ε \Sigma_\varepsilon Σ ε
推导组合方差在因子风险与特异风险之间的分解表达式;
证明每个因子的绝对风险贡献可写为 RC k = β p , k ( Σ f β p ) k σ ( w ) \operatorname{RC}_k = \beta_{p,k}\frac{(\Sigma_f \boldsymbol{\beta}_p)_k}{\sigma(\mathbf{w})} RC k = β p , k σ ( w ) ( Σ f β p ) k β p = B ⊤ w \boldsymbol{\beta}_p = B^\top \mathbf{w} β p = B ⊤ w
构造一个包含 2 资产、1 因子的具体数例,完整计算各部分的数值风险份额。
21-C02(稳健组合构建方案设计与回测规范)
针对股票多空量化策略,设计一套完整的实用组合构建方案。方案须明确包含:
数据时间戳与因果隔离;
协方差估计模型及抗病态处理;
风险中性约束与总杠杆控制;
换手控制与目标权重平滑逻辑;
明确列出评测失败条件(在何种量化证据下必须拒绝该策略上线)。
17.1 综合核对题
21-R01(费用金额守恒) 用8.2的55/45交易前权重、净值100万元、c=10bp,分别算50/50和100/0目标的精确费用及买卖金额;比较旧净值换手代理。两例是否都能证明真实滑点?
21-R02(数学对象与统计判断) 分别诊断:(a)长仓满仓上限可行但最大超额均值非正;(b)零风险正超额组合;(c)BL的后验均值协方差可否直接替换收益风险;(d)MinVar样本波动较低、收益差单项区间低于0、ERC Sharpe差跨0、W24事后结果。每项指出能与不能下的结论。
18. 练习答案与解析(Solutions)
21-E01
月均值标准误:
SE ( μ ^ ) = 0.06 36 = 0.06 6 = 0.010 ( 1.00 % ) .
\operatorname{SE}(\hat{\mu}) = \frac{0.06}{\sqrt{36}} = \frac{0.06}{6} = 0.010 \quad (1.00\%).
SE ( μ ^ ) = 36 0.06 = 6 0.06 = 0.010 ( 1.00% ) .
95 % 95\% 95% 1.96 1.96 1.96
0.5 % ± 1.96 × 1.0 % = [ − 1.46 % , + 2.46 % ] .
0.5\% \pm 1.96 \times 1.0\% = [-1.46\%, +2.46\%].
0.5% ± 1.96 × 1.0% = [ − 1.46% , + 2.46% ] .
置信区间极大,甚至无法确定真实期望超额收益是正还是负。无约束切点优化需要计算 Σ − 1 μ ^ \Sigma^{-1}\hat{\boldsymbol{\mu}} Σ − 1 μ ^ − 1.46 % -1.46\% − 1.46% + 2.46 % +2.46\% + 2.46%
21-E02
选择缩放单位阵 m I mI m I tr ( m I ) = tr ( S ) \operatorname{tr}(mI) = \operatorname{tr}(S) tr ( m I ) = tr ( S ) I I I
当 T → ∞ T \to \infty T → ∞ p p p S S S Σ \Sigma Σ β 2 → 0 \beta^2 \to 0 β 2 → 0 d 2 → α 2 d^2\to\alpha^2 d 2 → α 2 Σ \Sigma Σ α 2 > 0 \alpha^2>0 α 2 > 0 κ ^ = b 2 / d 2 → 0 \hat{\kappa} = b^2/d^2 \to 0 κ ^ = b 2 / d 2 → 0 S S S Σ \Sigma Σ μ I \mu I μ I
21-E03
21-E04
令权重为 w = ( 0.5 , 0.0 , − 0.5 ) ⊤ \mathbf{w} = (0.5, 0.0, -0.5)^\top w = ( 0.5 , 0.0 , − 0.5 ) ⊤ ∑ w i = 0.5 + 0.0 − 0.5 = 0.0 \sum w_i = 0.5 + 0.0 - 0.5 = 0.0 ∑ w i = 0.5 + 0.0 − 0.5 = 0.0
令 Beta 向量为 β = ( 1.5 , 1.0 , 0.3 ) ⊤ \boldsymbol{\beta} = (1.5, 1.0, 0.3)^\top β = ( 1.5 , 1.0 , 0.3 ) ⊤
β ⊤ w = 0.5 ( 1.5 ) + 0.0 ( 1.0 ) − 0.5 ( 0.3 ) = 0.75 − 0.15 = 0.60.
\boldsymbol{\beta}^\top \mathbf{w} = 0.5(1.5) + 0.0(1.0) - 0.5(0.3) = 0.75 - 0.15 = 0.60.
β ⊤ w = 0.5 ( 1.5 ) + 0.0 ( 1.0 ) − 0.5 ( 0.3 ) = 0.75 − 0.15 = 0.60. 满足 ∣ β ⊤ w ∣ = 0.60 ≥ 0.5 |\boldsymbol{\beta}^\top \mathbf{w}| = 0.60 \ge 0.5 ∣ β ⊤ w ∣ = 0.60 ≥ 0.5
21-E05
以下每次除以波动均要求 σ ( w ) > 0 \sigma(\mathbf w)>0 σ ( w ) > 0
对 σ ( w ) = ( w ⊤ Σ w ) 1 / 2 \sigma(\mathbf{w}) = (\mathbf{w}^\top \Sigma \mathbf{w})^{1/2} σ ( w ) = ( w ⊤ Σ w ) 1/2
∂ σ ( w ) ∂ w i = 1 2 ( w ⊤ Σ w ) − 1 / 2 ⋅ ∂ ( w ⊤ Σ w ) ∂ w i .
\frac{\partial \sigma(\mathbf{w})}{\partial w_i} = \frac{1}{2}(\mathbf{w}^\top \Sigma \mathbf{w})^{-1/2} \cdot \frac{\partial (\mathbf{w}^\top \Sigma \mathbf{w})}{\partial w_i}.
∂ w i ∂ σ ( w ) = 2 1 ( w ⊤ Σ w ) − 1/2 ⋅ ∂ w i ∂ ( w ⊤ Σ w ) . 根据二次型对向量求导法则,∂ ( w ⊤ Σ w ) ∂ w = 2 Σ w \frac{\partial (\mathbf{w}^\top \Sigma \mathbf{w})}{\partial \mathbf{w}} = 2\Sigma \mathbf{w} ∂ w ∂ ( w ⊤ Σ w ) = 2Σ w i i i 2 ( Σ w ) i 2(\Sigma \mathbf{w})_i 2 ( Σ w ) i
∂ σ ( w ) ∂ w i = 1 2 σ ( w ) ⋅ 2 ( Σ w ) i = ( Σ w ) i σ ( w ) .
\frac{\partial \sigma(\mathbf{w})}{\partial w_i} = \frac{1}{2\sigma(\mathbf{w})} \cdot 2(\Sigma \mathbf{w})_i = \frac{(\Sigma \mathbf{w})_i}{\sigma(\mathbf{w})}.
∂ w i ∂ σ ( w ) = 2 σ ( w ) 1 ⋅ 2 ( Σ w ) i = σ ( w ) ( Σ w ) i .
验证 Euler 恒等式:
∑ i = 1 n w i MRC i = ∑ i = 1 n w i ( Σ w ) i σ ( w ) = w ⊤ ( Σ w ) σ ( w ) = σ 2 ( w ) σ ( w ) = σ ( w ) .
\sum_{i=1}^n w_i \operatorname{MRC}_i = \sum_{i=1}^n w_i \frac{(\Sigma \mathbf{w})_i}{\sigma(\mathbf{w})} = \frac{\mathbf{w}^\top (\Sigma \mathbf{w})}{\sigma(\mathbf{w})} = \frac{\sigma^2(\mathbf{w})}{\sigma(\mathbf{w})} = \sigma(\mathbf{w}).
i = 1 ∑ n w i MRC i = i = 1 ∑ n w i σ ( w ) ( Σ w ) i = σ ( w ) w ⊤ ( Σ w ) = σ ( w ) σ 2 ( w ) = σ ( w ) . 证毕。
21-E06
对于两资产,协方差矩阵为 Σ = [ σ 1 2 ρ σ 1 σ 2 ρ σ 1 σ 2 σ 2 2 ] \Sigma = \begin{bmatrix} \sigma_1^2 & \rho \sigma_1 \sigma_2 \\ \rho \sigma_1 \sigma_2 & \sigma_2^2 \end{bmatrix} Σ = [ σ 1 2 ρ σ 1 σ 2 ρ σ 1 σ 2 σ 2 2 ]
RC 1 = w 1 ( Σ w ) 1 σ ( w ) = w 1 ( w 1 σ 1 2 + w 2 ρ σ 1 σ 2 ) σ ( w ) ;
\operatorname{RC}_1 = \frac{w_1 (\Sigma \mathbf{w})_1}{\sigma(\mathbf{w})} = \frac{w_1 (w_1 \sigma_1^2 + w_2 \rho \sigma_1 \sigma_2)}{\sigma(\mathbf{w})};
RC 1 = σ ( w ) w 1 ( Σ w ) 1 = σ ( w ) w 1 ( w 1 σ 1 2 + w 2 ρ σ 1 σ 2 ) ; RC 2 = w 2 ( Σ w ) 2 σ ( w ) = w 2 ( w 1 ρ σ 1 σ 2 + w 2 σ 2 2 ) σ ( w ) .
\operatorname{RC}_2 = \frac{w_2 (\Sigma \mathbf{w})_2}{\sigma(\mathbf{w})} = \frac{w_2 (w_1 \rho \sigma_1 \sigma_2 + w_2 \sigma_2^2)}{\sigma(\mathbf{w})}.
RC 2 = σ ( w ) w 2 ( Σ w ) 2 = σ ( w ) w 2 ( w 1 ρ σ 1 σ 2 + w 2 σ 2 2 ) .
令 RC 1 = RC 2 \operatorname{RC}_1 = \operatorname{RC}_2 RC 1 = RC 2
w 1 2 σ 1 2 + w 1 w 2 ρ σ 1 σ 2 = w 1 w 2 ρ σ 1 σ 2 + w 2 2 σ 2 2 .
w_1^2 \sigma_1^2 + w_1 w_2 \rho \sigma_1 \sigma_2 = w_1 w_2 \rho \sigma_1 \sigma_2 + w_2^2 \sigma_2^2.
w 1 2 σ 1 2 + w 1 w 2 ρ σ 1 σ 2 = w 1 w 2 ρ σ 1 σ 2 + w 2 2 σ 2 2 . 等式两侧的交叉项 w 1 w 2 ρ σ 1 σ 2 w_1 w_2 \rho \sigma_1 \sigma_2 w 1 w 2 ρ σ 1 σ 2
w 1 2 σ 1 2 = w 2 2 σ 2 2 .
w_1^2 \sigma_1^2 = w_2^2 \sigma_2^2.
w 1 2 σ 1 2 = w 2 2 σ 2 2 . 在长仓约束 w 1 , w 2 > 0 w_1, w_2 > 0 w 1 , w 2 > 0
w 1 σ 1 = w 2 σ 2 ⟺ w 1 w 2 = σ 2 σ 1 .
w_1 \sigma_1 = w_2 \sigma_2 \iff \frac{w_1}{w_2} = \frac{\sigma_2}{\sigma_1}.
w 1 σ 1 = w 2 σ 2 ⟺ w 2 w 1 = σ 1 σ 2 .
结合全额投资约束 w 1 + w 2 = 1 w_1 + w_2 = 1 w 1 + w 2 = 1
w 1 + w 1 σ 1 σ 2 = 1 ⟹ w 1 ( σ 1 + σ 2 σ 2 ) = 1 ⟹ w 1 = σ 2 σ 1 + σ 2 .
w_1 + w_1 \frac{\sigma_1}{\sigma_2} = 1 \implies w_1 \left(\frac{\sigma_1 + \sigma_2}{\sigma_2}\right) = 1 \implies w_1 = \frac{\sigma_2}{\sigma_1 + \sigma_2}.
w 1 + w 1 σ 2 σ 1 = 1 ⟹ w 1 ( σ 2 σ 1 + σ 2 ) = 1 ⟹ w 1 = σ 1 + σ 2 σ 2 . 公式中完全不包含相关系数 ρ \rho ρ
21-E07
21-E08
以下为月度二次增长代理,相对现金基准,忽略均值平方项;不是精确离散期望对数效用。
先写二阶展开。设组合简单收益为 R p = r f + w ( R − r f ) R_p=r_f+w(R-r_f) R p = r f + w ( R − r f ) a = r f + w ( μ − r f ) a=r_f+w(\mu-r_f) a = r f + w ( μ − r f ) w 2 σ 2 w^2\sigma^2 w 2 σ 2 ln ( 1 + x ) ≈ x − x 2 / 2 \ln(1+x)\approx x-x^2/2 ln ( 1 + x ) ≈ x − x 2 /2
E [ ln ( 1 + R p ) ] ≈ a − 1 2 E [ R p 2 ] = a − 1 2 { w 2 σ 2 + a 2 } .
E[\ln(1+R_p)]\approx a-\tfrac12 E[R_p^2]
=a-\tfrac12\{w^2\sigma^2+a^2\}.
E [ ln ( 1 + R p )] ≈ a − 2 1 E [ R p 2 ] = a − 2 1 { w 2 σ 2 + a 2 } . 此处使用 E [ R p 2 ] = Var ( R p ) + a 2 E[R_p^2]=\operatorname{Var}(R_p)+a^2 E [ R p 2 ] = Var ( R p ) + a 2
本题再采用忽略均值平方项 a 2 a^2 a 2
g ( w ) ≈ r f + w ( μ − r f ) − 1 2 w 2 σ 2 .
g(w) \approx r_f + w(\mu - r_f) - \frac{1}{2}w^2 \sigma^2.
g ( w ) ≈ r f + w ( μ − r f ) − 2 1 w 2 σ 2 .
全额 Kelly 最优权重:
w ∗ = μ − r f σ 2 = 0.008 0.0025 = 3.20 ( 3.20 倍杠杆 ) .
w^* = \frac{\mu - r_f}{\sigma^2} = \frac{0.008}{0.0025} = 3.20 \quad (3.20\text{ 倍杠杆}).
w ∗ = σ 2 μ − r f = 0.0025 0.008 = 3.20 ( 3.20 倍杠杆 ) .
全额 Kelly 的期望对数超额增长率:
g ( w ∗ ) − r f = 3.20 ( 0.008 ) − 1 2 ( 3.20 2 ) ( 0.0025 ) = 0.0256 − 0.0128 = 0.0128 ( 1.28 % ) .
\begin{aligned}
g(w^*) - r_f &= 3.20(0.008) - \tfrac{1}{2}(3.20^2)(0.0025)\\
&= 0.0256 - 0.0128 = 0.0128 \quad (1.28\%).
\end{aligned}
g ( w ∗ ) − r f = 3.20 ( 0.008 ) − 2 1 ( 3.2 0 2 ) ( 0.0025 ) = 0.0256 − 0.0128 = 0.0128 ( 1.28% ) .
半 Kelly 权重 w h a l f = 1.60 w_{half} = 1.60 w ha l f = 1.60
g ( w h a l f ) − r f = 1.60 ( 0.008 ) − 1 2 ( 1.60 2 ) ( 0.0025 ) = 0.0128 − 0.0032 = 0.0096 ( 0.96 % ) .
\begin{aligned}
g(w_{half}) - r_f &= 1.60(0.008) - \tfrac{1}{2}(1.60^2)(0.0025)\\
&= 0.0128 - 0.0032 = 0.0096 \quad (0.96\%).
\end{aligned}
g ( w ha l f ) − r f = 1.60 ( 0.008 ) − 2 1 ( 1.6 0 2 ) ( 0.0025 ) = 0.0128 − 0.0032 = 0.0096 ( 0.96% ) . 核算:0.0096 / 0.0128 = 0.75 0.0096 / 0.0128 = 0.75 0.0096/0.0128 = 0.75 75 % 75\% 75%
21-P01 至 21-P03 参考实现与断言
以下 Python 代码可直接在仓库根目录下独立运行并完成验收断言:
import numpy as np
from quant_course.portfolio_construction import (
ledoit_wolf_identity, risk_budget_weights, risk_contributions,
max_sharpe_long_only,
)
from quant_course.optimization_tools import solve_mean_variance, OptimizationError
vol_mrt = np.array([0.10 , 0.20 , 0.30 , 0.40 ])
corr_mrt = np.array([
[1.0 , 0.8 , 0.0 , 0.0 ],
[0.8 , 1.0 , 0.0 , 0.0 ],
[0.0 , 0.0 , 1.0 , -0.5 ],
[0.0 , 0.0 , -0.5 , 1.0 ],
])
cov_mrt = np.outer(vol_mrt, vol_mrt) * corr_mrt
ew_res = risk_contributions(np.full(4 , 0.25 ), cov_mrt)
assert np.isclose(ew_res.volatility, 0.1151086 , atol=1e-4 )
np.testing.assert_allclose(ew_res.fractions, [0.123 , 0.264 , 0.141 , 0.472 ], atol=1e-3 )
mv_weights = solve_mean_variance(np.zeros(4 ), cov_mrt).weights
mv_res = risk_contributions(mv_weights, cov_mrt)
assert np.isclose(mv_res.volatility, 0.086303 , atol=1e-4 )
np.testing.assert_allclose(mv_weights, [0.7448 , 0.0 , 0.1517 , 0.1034 ], atol=1e-3 )
erc_weights = risk_budget_weights(cov_mrt).weights
erc_res = risk_contributions(erc_weights, cov_mrt)
assert np.isclose(erc_res.volatility, 0.102934 , atol=1e-4 )
np.testing.assert_allclose(erc_weights, [0.3836 , 0.1918 , 0.2426 , 0.1820 ], atol=1e-3 )
np.testing.assert_allclose(erc_res.fractions, 0.25 , atol=1e-6 )
assert mv_res.volatility <= erc_res.volatility <= ew_res.volatility
rng = np.random.default_rng(20261021 )
x_low_rank = rng.standard_normal((10 , 20 ))
lw_low_rank = ledoit_wolf_identity(x_low_rank)
assert np.linalg.matrix_rank(lw_low_rank.sample_covariance) <= 10
min_eig = np.linalg.eigvalsh(lw_low_rank.covariance).min ()
assert min_eig > 0.0
assert lw_low_rank.intensity > 0.0
mu_infeasible = np.array([0.004 , -0.004 , -0.004 ])
cov_diag = np.diag([0.01 , 0.01 , 0.01 ])
try :
max_sharpe_long_only(
mu_infeasible, cov_diag, risk_free_return=0.0 , max_weight=0.4 ,
)
except OptimizationError as exc:
assert "capped long-only portfolio has positive expected excess return" in str (exc)
else :
raise AssertionError("expected OptimizationError was not raised" )
21-C01
条件:Cov ( f , ε ) = 0 \operatorname{Cov}(\mathbf f,\boldsymbol\varepsilon)=0 Cov ( f , ε ) = 0 Σ ε \Sigma_\varepsilon Σ ε σ ( w ) > 0 \sigma(\mathbf w)>0 σ ( w ) > 0 Σ f \Sigma_f Σ f
方差分解 :
在因子模型 r = B f + ε \mathbf{r} = B\mathbf{f} + \boldsymbol{\varepsilon} r = B f + ε Σ = B Σ f B ⊤ + Σ ε \Sigma = B \Sigma_f B^\top + \Sigma_\varepsilon Σ = B Σ f B ⊤ + Σ ε
σ 2 ( w ) = w ⊤ Σ w = w ⊤ B Σ f B ⊤ w + w ⊤ Σ ε w = β p ⊤ Σ f β p + ∑ i = 1 n w i 2 ( Σ ε ) i i ,
\begin{aligned}
\sigma^2(\mathbf{w}) &= \mathbf{w}^\top \Sigma \mathbf{w} = \mathbf{w}^\top B \Sigma_f B^\top \mathbf{w} + \mathbf{w}^\top \Sigma_\varepsilon \mathbf{w}\\
&= \boldsymbol{\beta}_p^\top \Sigma_f \boldsymbol{\beta}_p + \sum_{i=1}^n w_i^2 (\Sigma_\varepsilon)_{ii},
\end{aligned}
σ 2 ( w ) = w ⊤ Σ w = w ⊤ B Σ f B ⊤ w + w ⊤ Σ ε w = β p ⊤ Σ f β p + i = 1 ∑ n w i 2 ( Σ ε ) ii , 其中 β p = B ⊤ w ∈ R K \boldsymbol{\beta}_p = B^\top \mathbf{w} \in \mathbb{R}^K β p = B ⊤ w ∈ R K K K K
因子风险贡献分解 :
把第 1 步写成逐项求和:
σ 2 ( w ) = ∑ k = 1 K β p , k ( Σ f β p ) k + ∑ i = 1 n w i 2 ( Σ ε ) i i .
\sigma^2(\mathbf{w}) = \sum_{k=1}^K \beta_{p,k}(\Sigma_f \boldsymbol{\beta}_p)_k + \sum_{i=1}^n w_i^2 (\Sigma_\varepsilon)_{ii}.
σ 2 ( w ) = k = 1 ∑ K β p , k ( Σ f β p ) k + i = 1 ∑ n w i 2 ( Σ ε ) ii . 两边除以 σ ( w ) \sigma(\mathbf{w}) σ ( w )
RC f a c t o r , k = β p , k ( Σ f β p ) k σ ( w ) , RC s p e c , i = w i 2 ( Σ ε ) i i σ ( w ) ,
\operatorname{RC}_{factor, k} = \beta_{p,k}\frac{(\Sigma_f \boldsymbol{\beta}_p)_k}{\sigma(\mathbf{w})},\qquad
\operatorname{RC}_{spec, i} = \frac{w_i^2 (\Sigma_\varepsilon)_{ii}}{\sigma(\mathbf{w})},
RC f a c t or , k = β p , k σ ( w ) ( Σ f β p ) k , RC s p ec , i = σ ( w ) w i 2 ( Σ ε ) ii , 则 ∑ k RC f a c t o r , k + ∑ i RC s p e c , i = σ ( w ) \sum_k\operatorname{RC}_{factor,k}+\sum_i\operatorname{RC}_{spec,i}=\sigma(\mathbf{w}) ∑ k RC f a c t or , k + ∑ i RC s p ec , i = σ ( w ) σ \sigma σ β p \boldsymbol{\beta}_p β p ∂ σ / ∂ β p , k = ( Σ f β p ) k / σ \partial\sigma/\partial\beta_{p,k}=(\Sigma_f\boldsymbol{\beta}_p)_k/\sigma ∂ σ / ∂ β p , k = ( Σ f β p ) k / σ RC f a c t o r , k \operatorname{RC}_{factor,k} RC f a c t or , k
两资产单因子算例 :
设 β = [ 1.2 , 0.8 ] ⊤ \beta = [1.2, 0.8]^\top β = [ 1.2 , 0.8 ] ⊤ Σ f = 0.04 \Sigma_f = 0.04 Σ f = 0.04 Σ ε = diag ( 0.01 , 0.02 ) \Sigma_\varepsilon = \operatorname{diag}(0.01, 0.02) Σ ε = diag ( 0.01 , 0.02 ) w = [ 0.6 , 0.4 ] ⊤ \mathbf{w} = [0.6, 0.4]^\top w = [ 0.6 , 0.4 ] ⊤
组合因子暴露:β p = 0.6 ( 1.2 ) + 0.4 ( 0.8 ) = 0.72 + 0.32 = 1.04 \beta_p = 0.6(1.2) + 0.4(0.8) = 0.72 + 0.32 = 1.04 β p = 0.6 ( 1.2 ) + 0.4 ( 0.8 ) = 0.72 + 0.32 = 1.04
因子方差成分:σ f a c t o r 2 = ( 1.04 ) 2 × 0.04 = 0.043264 \sigma_{factor}^2 = (1.04)^2 \times 0.04 = 0.043264 σ f a c t or 2 = ( 1.04 ) 2 × 0.04 = 0.043264
特异方差成分:σ s p e c 2 = 0.6 2 ( 0.01 ) + 0.4 2 ( 0.02 ) = 0.0036 + 0.0032 = 0.0068 \sigma_{spec}^2 = 0.6^2(0.01) + 0.4^2(0.02) = 0.0036 + 0.0032 = 0.0068 σ s p ec 2 = 0. 6 2 ( 0.01 ) + 0. 4 2 ( 0.02 ) = 0.0036 + 0.0032 = 0.0068
组合总方差:σ 2 = 0.043264 + 0.0068 = 0.050064 ⟹ σ ≈ 0.22375 \sigma^2 = 0.043264 + 0.0068 = 0.050064 \implies \sigma \approx 0.22375 σ 2 = 0.043264 + 0.0068 = 0.050064 ⟹ σ ≈ 0.22375 22.375 % 22.375\% 22.375%
因子绝对风险贡献:RC f a c t o r = 0.043264 0.22375 ≈ 0.19336 \operatorname{RC}_{factor} = \frac{0.043264}{0.22375} \approx 0.19336 RC f a c t or = 0.22375 0.043264 ≈ 0.19336 86.42 % 86.42\% 86.42%
特异绝对风险贡献:RC s p e c = 0.0068 0.22375 ≈ 0.03039 \operatorname{RC}_{spec} = \frac{0.0068}{0.22375} \approx 0.03039 RC s p ec = 0.22375 0.0068 ≈ 0.03039 13.58 % 13.58\% 13.58%
21-C02
评分标准(满分 10 分) :
时点与因果性规范(2 分) :决策时间戳 t − 1 t-1 t − 1 协方差估计与数值稳健性(2 分) :采用 Ledoit–Wolf 收缩或因子模型结构化估计,严禁直接求逆病态样本协方差,优化器具备尺度归一化与正定保护。真实约束架构(2 分) :明确建立总暴露(杠杆)、单股上限、行业中性与 Beta 中性约束体系,不采用破坏信息的纯几何欧氏投影。成本与换手控制(2 分) :目标权重包含换手惩罚项(如二次或绝对值成本项)或缓冲带(buffer rules),建立扣费后真实净收益核算。严谨的证伪与上线门槛(2 分) :预设不可妥协的证伪标准——可为本挑战题提出一套教学示例门槛(不是普遍业界标准):若策略净夏普比率在成对 Bootstrap 下未显著超越 1/N 基准,或对交易成本敏感度过高(成本上升 10 bps 导致 Sharpe 下降超 20 % 20\% 20% 1 % 1\% 1%
21-R01
50/50:q=0.0001,费用100元,新持仓各499,950元;卖50,050元、买49,950元,差100元支付费用,成交合计100,000元,代理同值。100/0:q=0.0009/1.001=0.0008991009,费用899.1009元,新资产1金额999,100.8991元;从550,000元买入449,100.8991元,卖出资产2的450,000元,差899.1009元付费。成交合计899,100.8991元,乘0.001得到费用;代理以900,000元成交量收费900元。资金守恒检查成立,但模型无实际滑点、冲击、订单和容量,不能证明实盘费用。
21-R02
(a)预算可行不代表正Sharpe变换可用;保留等权回退原因,不把所有头寸称不可行。(b)普通有限Sharpe分母为0;半正定凸QP可得目标0,却不能读成有限最优比率。(c)V_BL是均值估计不确定性;在独立新噪声的层级模型下预测风险才是Sigma+V_BL,原BL配置用Sigma,换目标须重解。(d)波动/回撤降低只作样本描述;未校正均值差区间只支撑该单项主规格,不扩成家族显著性或波动显著性;ERC区间跨0不是等价证明或优势概率;W24是事后探索,不增加预设敏感性验证、不替换主规格。
19. 延伸阅读(Further Reading)
Must Know :
Ledoit & Wolf(2004),阅读作者工作论文版 §2.1 与 §3,掌握收缩强度可行估计量推导及 Frobenius 范数定义;
Maillard, Roncalli & Teiletche(2009/2010),阅读 §1–§3.4,掌握波动率 Euler 分解、两资产无依性与凸对数障碍优化表示。
Should Know :
He & Litterman(1999),阅读 Appendix B,掌握反向优化先验确定、增益形式后验均值以及观点正交倾斜性质;
DeMiguel, Garlappi & Uppal(2009),阅读 NBER 会议稿 §3,理解滚动样本外回测规范、交易前漂移换手率计算及 1/N 朴素基准的现实挑战。
Advanced :
Boyd & Vandenberghe《Convex Optimization》§9.5,研读阻尼 Newton 法与 Newton 减量停止准则的收敛性分析;
Kelly(1956),阅读 Bell System Technical Journal 扫描版 pp. 919–920,理解二元几何对数增长极值定理与破产界限。
Optional :
20. 参考文献(References)
CH21_LEDOITWOLF2004 :Olivier Ledoit and Michael Wolf, “A well-conditioned estimator for large-dimensional covariance matrices,” Journal of Multivariate Analysis , 88(2), 365–411, 2004. DOI: 10.1016/S0047-259X(03)00096-4 。工作论文版:http://www.ledoit.net/ole1a.pdf 。实际读取范围见 来源读取记录 。CH21_MRT2009 :Sébastien Maillard, Thierry Roncalli, and Jérôme Teiletche, “On the properties of equally-weighted risk contributions portfolios,” Journal of Portfolio Management , 36(4), 60–70, 2010. DOI: 10.3905/jpm.2010.36.4.060 。工作论文版:http://www.thierry-roncalli.com/download/erc.pdf 。实际读取范围见 来源读取记录 。CH21_HELITTERMAN1999 :Guangliang He and Robert Litterman, “The Intuition Behind Black-Litterman Model Portfolios,” Goldman Sachs Asset Management Research, 1999. Duke 托管副本:https://people.duke.edu/~charvey/Teaching/BA453_2006/GS_The_intuition_behind.pdf 。实际读取范围见 来源读取记录 。CH21_KELLY1956 :J. L. Kelly, Jr., “A New Interpretation of Information Rate,” Bell System Technical Journal , 35(4), 917–926, 1956. DOI: 10.1002/j.1538-7305.1956.tb03809.x 。扫描版:https://archive.org/details/bstj35-4-917 。实际读取范围见 来源读取记录 。CH21_DGU2009 :Victor DeMiguel, Lorenzo Garlappi, and Raman Uppal, “Optimal versus naive diversification: How inefficient is the 1/N portfolio strategy?” Review of Financial Studies , 22(5), 1915–1953, 2009. DOI: 10.1093/rfs/hhm075 。NBER 会议稿:https://users.nber.org/~confer/2006/si2006/ap/uppal.pdf 。实际读取范围见 来源读取记录 。SHARPE1994 :William F. Sharpe, “The Sharpe Ratio,” Journal of Portfolio Management , Fall 1994(卷期页码未在已读网页上核实)。作者网页版:https://web.stanford.edu/~wfsharpe/art/sr/sr.htm 。LESNIEWSKI2019 :Andrew Lesniewski, “Optimization Techniques in Finance — 5. Convex optimization. II,” Baruch College MFE 讲义(文件名 Opt_Lecture5_2019.pdf)。 https://mfe.baruch.cuny.edu/wp-content/uploads/2014/12/Opt_Lecture5_2019.pdf 。BOYD :Stephen Boyd and Lieven Vandenberghe, Convex Optimization , Cambridge University Press, 2004. https://web.stanford.edu/~boyd/cvxbook/ 。CVXPY :Steven Diamond and Stephen Boyd, “CVXPY: A Python-embedded modeling language for convex optimization,” Journal of Machine Learning Research , 17(83), 1–5, 2016. https://www.cvxpy.org/ 。FRENCH :Kenneth R. French Data Library, 10 Industry Portfolios 与 Fama/French Factors 。数据快照与哈希见本地 manifest,实际读取范围见 来源读取记录 。