第 5 章/ 45
线性代数(Linear Algebra):把组合与风险写成有维度的对象
主线:矩阵是一套同时处理很多资产的语言;维度、方向和样本含义正确,计算才有金融意义。 先修:第2章数组与索引;普通代数。第6章会正式展开概率与协方差,本章先用给定的协方差矩阵解释几何与运算。主成分分析(Principal Component Analysis, PCA)的训练窗口遵守第3章的信息时间契约。
1. 本章目标
完成本章,你应能把持仓权重写成向量(Vector),把多资产收益写成矩阵(Matrix),在计算前说明每个轴代表什么。你还要解释矩阵乘法(Matrix Multiplication)、转置(Transpose)、秩(Rank)、基(Basis)与正交性(Orthogonality),识别不可逆和数值病态的系统。
风险部分的验收是从两资产的展开式推导组合方差,判断一个候选矩阵是否可能是协方差矩阵(Covariance Matrix)。降维部分的验收是读懂奇异值分解(Singular Value Decomposition, SVD)与主成分分析(Principal Component Analysis, PCA):训练数据怎样中心化,主成分是什么方向,解释方差是什么量,未来数据为什么不能参与拟合。
你不需要此时掌握所有抽象线性空间定理。必须能完成的是:核对维度、手算小例子、理解关键条件,再用程序检验结果。第8章会用这些对象推导回归,第9章和第20章会用它们求组合。
2. 为什么 Quant 需要它
研究只有一只股票时,可以逐个数计算。研究500只股票时,同一天有500个收益、500个权重、数十个行业暴露,以及一个500×500的风险矩阵。逐项写公式既容易漏项,也难检查日期和资产次序。线性代数把这些关系压缩成几个有明确形状的运算。
压缩并不替你做经济判断。一个求解器能给出数字,却不知道你把月度协方差与年度预期收益混在一起,也不知道第17列已从某只股票变成另一只。矩阵离开标签以后,只剩位置。数据工程负责标签与可用时间;线性代数负责在这些条件成立后计算。
这里会反复使用三个对象:收益面板、权重向量和协方差矩阵。第2章已经介绍数组广播,本章解释它为什么能产生组合收益;第21章再讨论估计误差与真实投资约束。我们先把运算读懂,再讨论最优投资。
3. 直觉
你可以把权重向量想成一张配方:第一项取多少A,第二项取多少B。收益向量则记录这两种原料在同一持有区间贡献了多少变化。内积(Inner Product)把“配方×每种原料的变化”加起来。
矩阵可以像一台多通道转换器:输入一个权重向量,输出每个日期的组合收益;也可以输入资产持仓,输出行业、市场或风格的总暴露。相同的矩阵形状不保证相同的含义——收益面板与风险矩阵都是二维对象,行列却代表不同东西。
风险矩阵的几何尤其重要。两只股票可能都很波动,但它们的变动不完全同步;组合波动既取决于各自风险,也取决于共同移动的部分。特征向量(Eigenvector)找出矩阵作用下方向不变的轴,特征值(Eigenvalue)告诉你沿这些轴伸缩多少。对于风险矩阵,这些轴描述不同组合方向的方差。
PCA相当于转动坐标系,让第一根轴沿数据最分散的方向,第二根轴沿剩余的、与第一根垂直的最分散方向。转动坐标不等于预测未来;找到“历史上声音最大的方向”,也不等于找到“最有投资价值的方向”。
4. 数学基础
4.1 向量、长度与转置
本课程默认把资产向量写成列向量:
是一个标量(Scalar),不是两维数组。若权重不是区间起始的实际持有权重,这个代数结果还不能被称为已实现组合收益。
两个向量
把转置和内积代入一个小例子:区间开始时持有
结果是0.8%的组合收益,形状为标量。权重对应区间开始时实际持有的比例;若它们是看见本区间收益后才选出的数字,这个乘积就不再是无前视的已实现收益。
4.2 收益面板与矩阵乘法
令
矩阵
固定矩阵
第一列是输入基向量
再把两个矩阵相乘,亲手算出每一个格子:
每格都取左侧的一行与右侧的一列做内积。收益面板
逐元素乘积(Elementwise Product)又称Hadamard乘积,@做矩阵乘法,*做逐元素乘法。它们都可能返回看似合理的数字;核对运算目的与形状才能区分。
4.3 线性组合、张成空间、基与秩
向量
基是一组线性无关、又能张成目标空间的向量。二维平面的标准基是
看列向量就能在二维图上读秩:矩阵
矩阵的秩是其列空间的维数,也等于行空间的维数。例如第二列恰好是第一列的2倍,则第二列没有提供新的线性方向。一个有100列的因子表,若很多列互为线性组合,独立信息方向可能远少于100。
零空间(Null Space)为
4.4 正交与投影
非零向量
把向量
例如
4.5 线性方程、可逆与条件数
线性方程组
数值计算优先调用solve(A,b),而不是先构造全部逆矩阵。你要的是某个右端项的解,不必为此计算每个可能右端项的逆映射。解出来以后还需检查残差(Residual)
例如solve(A, b)直接寻找这个solve也不会修复病态输入,条件数大时仍需检查结果对输入误差的敏感性。
可逆不等于稳定。二范数条件数(Condition Number)为
这里
5. 正式定义
5.1 对称、正定与半正定
5.2 协方差矩阵
本章先把协方差矩阵
对角线是A、B各自的方差,非对角线表示共同移动程度。你可以先用这张表计算组合风险,不需要先掌握概率论。
从收益分布追溯时,若同一持有区间的资产收益向量
波动率(Volatility)
5.3 特征值与谱分解
非零向量
时,
eigh返回对称矩阵的特征值与列特征向量;它使用一个三角部分,不能替你判断输入是否真的对称。
5.4 SVD与PCA
任意实矩阵
在紧凑计算形式中令
PCA对训练样本中心化后,寻找彼此正交、按投影样本方差从大到小排序的方向。主成分方向是
这里“中心化”是逐列减去训练均值:
对保留的components形状是(X-center) @ components.T。
下一窗口只做变换:
6. 推导
6.1 从两资产展开到组合方差
给定在收益区间开始时已确定的权重
期望的线性性给出
标量的平方可写成自身与转置相乘:
第二步把确定的
交叉项出现两次,因为
从矩阵乘法逐格看,
协方差矩阵对称时,两个交叉项相等,合并成
6.2 为什么协方差必为半正定
任意
右侧是平方的期望,因此不能为负。若某个非零
对共同完整样本估计协方差时,先逐列减均值,令
中心化后各列之和为零,等价于inv把信息凭空补出来。
6.3 沿风险主轴读方差
将
6.4 PCA为何选择最大特征值方向
令训练均值
第一主轴最大化这个量。写成特征基
SVD使计算更直接:
7. 金融解释
7.1 分散化来自共同移动程度
给定两资产波动率20%、30%,相关系数
7.2 小特征值也可能带来大问题
求解
用稳定算法求解病态估计,并不会消除经济估计误差。协方差收缩(Covariance Shrinkage)、正则化(Regularization)与持仓限制可以控制敏感性,第8、21章展开;它们会引入模型选择和偏差,需要样本外评价。
7.3 PCA在研究中的合理角色
PCA可以压缩相似资产的共同变化、诊断收益面板近重复列、观察风险方向是否集中,也可作为后续模型的候选特征变换。PCA的方向不是天然可交易组合:资产单位、预算、做空限制、成交成本和方向符号都需另外定义。
PCA无监督(Unsupervised),不使用目标标签;高解释方差可能只是共同市场波动。一个低方差方向反而可能与某个标签有关,一个高方差方向也可能没有预测作用。因此挑选主成分个数不能只凭“覆盖95%方差”就宣布交易有效。第41章再讨论降维与模型选择,本章先把几何和时间边界写清楚。
8. Numerical Example
8.1 两资产组合:逐项算风险
以下均为教学构造。给定未来一个年度持有区间的期望收益与协方差,不由日收益估计、也不声称是当前市场参数:
- 期望组合收益:
,即6.2%。 - 先算矩阵行的两个分量:第一格
,第二格 ,所以 。 - 再与权重做内积:
。 - 拆成原矩阵的四格:
, , , 。合计0.0336。 - 开平方得波动率:
,即18.33%。
把0.0336直接写成“波动率3.36%”混淆了方差与标准差。分别加两个方差贡献而漏掉交叉项,会算成0.0288;它不是本例的组合方差。
若改成完全正相关而保持两资产波动率不变,协方差变为
8.2 秩亏方程:列数不等于方向数
令
第二行是第一行的2倍;第二列也是第一列的2倍,因此秩为1。方程其实只给出一个独立条件
若把
8.3 特征值、可逆与预算约束
对8.1的
二者为正,所以
现在只把
左上项乘回后为
8.4 三行样本的PCA:手算到重构
9. Python Implementation
默认读者包入口(承接接受I3)
从读者安装说明建立环境,在读者包根运行:
.venv/bin/python run_notebook.py notebooks/ch05_linear_algebra.ipynb
默认Notebook调用随包共享实现,不读取未随包提供的French数据、不下载数据;新运行和图写入唯一runs子目录。读者CLI使用UUID目录并拒绝覆盖。未随包提供的旧测试位置只是原制作验收记录;读者使用Notebook内断言。French输入仅按可选数据契约提供,本批未重跑。下面保留原课程根脚本路线,与读者包入口分别使用各自环境。
共享PCA实现只接收训练矩阵,返回训练均值、按行存储的成分方向、解释方差、方差比与训练得分。输入至少两行一列、全为有限实数;不自行填NaN或标准化;全体列总方差为零时明确报错。实用脚本为code/ch05_linear_algebra.py,执行Notebook为ch05_linear_algebra.ipynb。先按环境说明安装本地项目,然后在课程根目录运行:
.venv/bin/python tools/run_a2.py --chapter 5
以下片段各自可独立运行。第一段把数学形状与NumPy输出对应起来:NumPy一维数组不是严格的列矩阵,但@定义了相应向量收缩;需要显式二维列形状时用reshape(-1,1)。
import numpy as np

asset_returns = np.array([[0.02, -0.01], [-0.03, 0.04]])
weights = np.array([0.6, 0.4])
portfolio_returns = asset_returns @ weights
assert asset_returns.shape == (2, 2)
assert weights.shape == (2,)
assert portfolio_returns.shape == (2,)
assert np.allclose(portfolio_returns, [0.008, -0.002])
assert np.allclose(portfolio_returns, (asset_returns * weights).sum(axis=1))
print(portfolio_returns)
这里的两行表示两个给定持有区间,收益为小数;没有信号或成交安排,因此这里只检查乘法,不宣称回测。列顺序A、B必须与权重次序一致。
第二段核对给定年度风险矩阵,既检查代数等式,也检查对称性、特征值和约束。eigh返回升序特征值,PCA通常按降序选取,两者顺序不要混用。NumPy文档说明了返回顺序及三角部分约定。
import numpy as np

covariance = np.array([[0.04, 0.01], [0.01, 0.09]])
expected_returns = np.array([0.05, 0.08])
weights = np.array([0.6, 0.4])
assert np.allclose(covariance, covariance.T)
eigenvalues, directions = np.linalg.eigh(covariance)
assert eigenvalues.min() > 0.0
assert np.allclose(directions.T @ directions, np.eye(2))
assert np.allclose(covariance @ directions, directions * eigenvalues)
variance = float(weights @ covariance @ weights)
assert np.isclose(variance, 0.0336)
assert np.isclose(weights @ expected_returns, 0.062)
solution = np.linalg.solve(covariance, expected_returns)
assert np.linalg.norm(covariance @ solution - expected_returns) < 1e-12
assert not np.isclose(solution.sum(), 1.0)
print(variance, np.sqrt(variance), eigenvalues, solution)
第三段从同一个有限样本矩阵构造协方差,使用SVD与特征值相互校验。它是教学几何数组,没有时间索引或交易语义。
import numpy as np
from quant_course.math_tools import pca_fit_transform

samples = np.array([[1.0, 2.0], [2.0, 4.0], [3.0, 6.0]])
result = pca_fit_transform(samples, n_components=1)
centered = samples - result.center
sample_covariance = centered.T @ centered / (len(samples) - 1)
assert np.allclose(sample_covariance, [[1.0, 2.0], [2.0, 4.0]])
assert np.isclose(result.explained_variance[0], 5.0)
assert np.isclose(result.explained_variance_ratio[0], 1.0)
assert np.allclose(result.projection @ result.components + result.center, samples)
print(result.center, result.explained_variance, result.explained_variance_ratio)
脚本的较大例子构造252个日观测、4个虚构资产,随机种子20261005。日期为带UTC时区的普通工作日索引,没有交易所节假日日历。前180行用于拟合,后72行留出;训练区间2024-01-02至2024-09-09。它不产生交易信号、不模拟成交,也不报告策略收益。拟合得到解释方差份额约为56.96%、20.19%、14.36%、8.49%。数值应由实际输出读取,不因接近某个“漂亮比例”修改样本。
未来行若要转换,只能用已拟合的center与components:(X_later-center) @ components.T,而不是把未来行拼回训练集再SVD。第18节给可运行对照。数据缺失需在训练流程中另定规则;共享PCA拒绝缺失,避免隐式零填补改变协方差。
10. Visualization
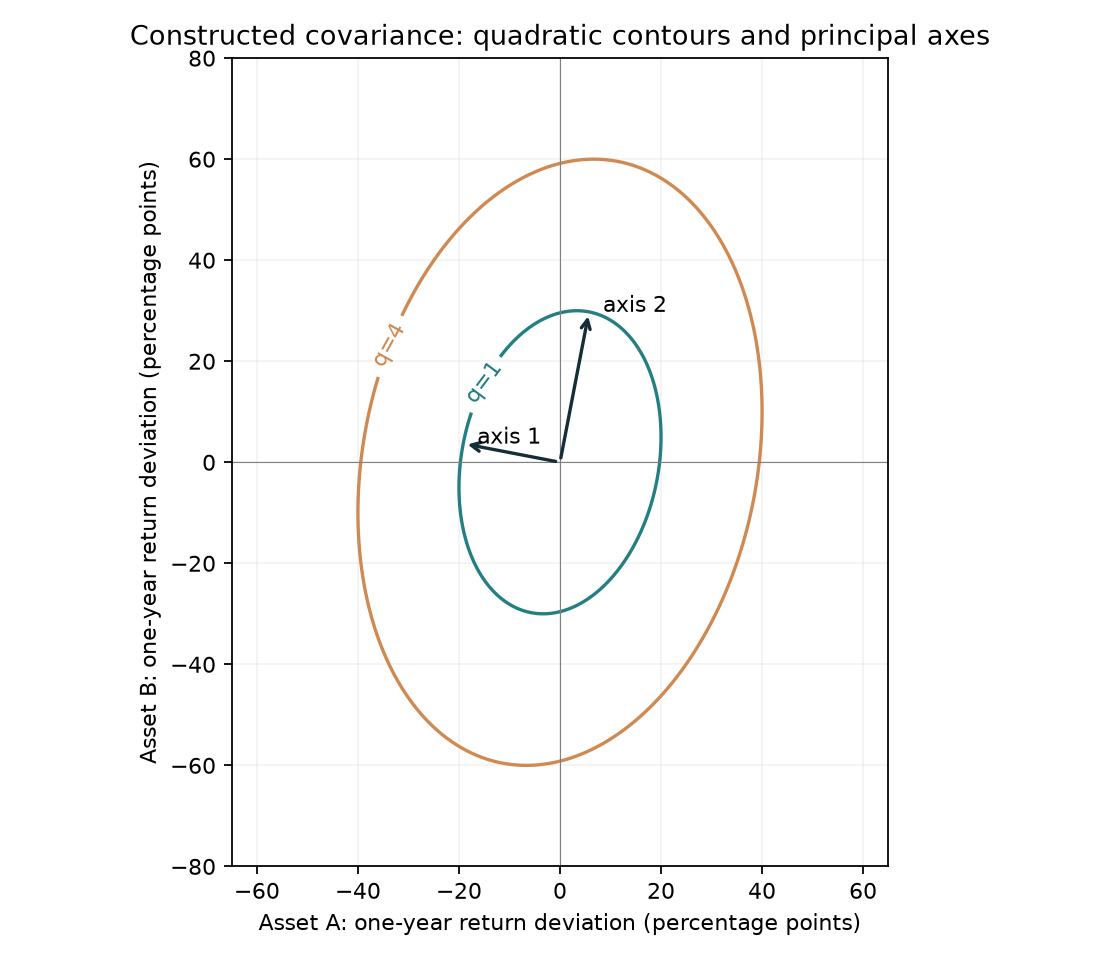
这张几何图使用8.1的给定年度矩阵。横轴是资产A的年度收益偏离、纵轴是资产B的偏离,均用百分点。曲线满足
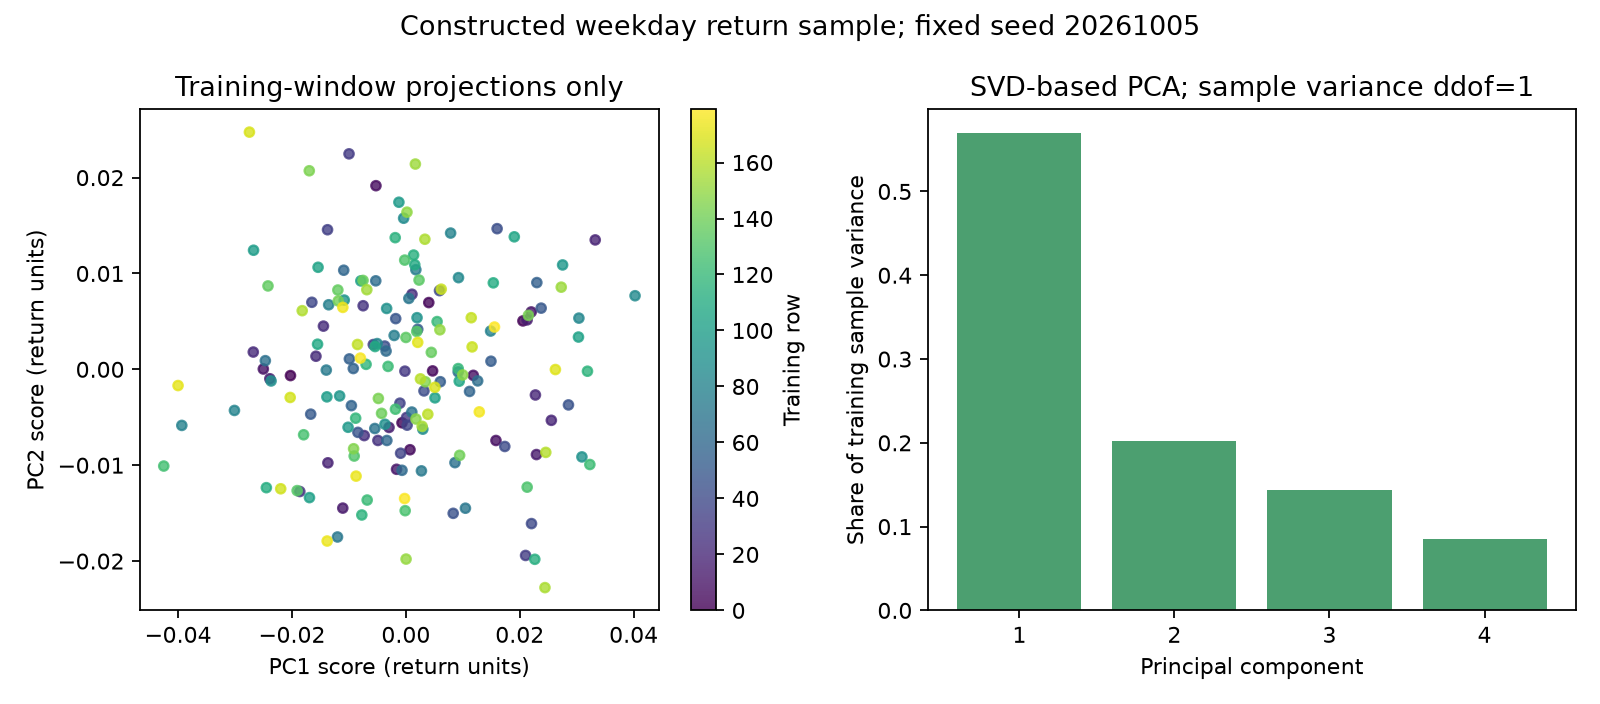
左图横轴是第一主成分得分、纵轴是第二主成分得分,均保持收益小数单位;每个点是一行训练观测,颜色从早到晚表示训练行号。你应观察点在两个主方向上的展开,并注意这不是价格图或策略净值图。横轴方差更大,是第一方向被这样选择出来的结果,不是独立的投资证据。
右图横轴是成分序号,纵轴是该成分解释的训练样本方差份额。前两个成分合计约77.15%,保留两个方向会丢掉剩余约22.85%的训练变化。未来数据可能有不同份额,因此不能把训练柱状图当作持久风险结构。
这张图没有对特征逐列标准化,也没有白化(Whitening)。白化会进一步缩放成分以改变其方差口径;第41章讨论何时需要。当前图的解释只针对所述中心化与SVD,不把不同预处理结果混在一起。
11. Real Market Example
第2章已读取Kenneth French真实10行业月度组合收益缓存。本章可以把该文件组织成“月份×行业”的矩阵,检查共同样本协方差与PCA。这里研究的是发布的行业组合收益方向,不是逐股风险模型,也不是可成交行业组合策略。源日期代表收益月份,不能被解释成数据在月末收盘已可用于当场交易。
下面程序以2010年1月至2019年12月的共同完整月份为训练窗口;它打印行数与实际解释方差。实际执行的前三方差份额为71.6043%、7.5198%、7.1064%,见运行记录。这些比例只描述当前快照和固定窗口,不构成经济因子命名或未来能力证据。2020年及以后没有进入拟合;即便如此,当前下载版本可能含历史修订,不能因此称作当年的时点可得(Point-in-Time, PIT)研究。这个区别来自第3章的版本时间契约。
from pathlib import Path
import numpy as np
import pandas as pd
from quant_course.math_tools import pca_fit_transform

path = Path("data/processed/french_10_industries_monthly.csv")
raw = pd.read_csv(path, dtype={"month": "string"})
monthly = raw.set_axis(pd.PeriodIndex(raw.pop("month"), freq="M"), axis="index")
train = monthly.loc["2010-01":"2019-12"].dropna(axis=0, how="any")
assert train.index.is_monotonic_increasing and train.index.is_unique
assert len(train) == 120
fit = pca_fit_transform(train.to_numpy(), n_components=3)
covariance = np.cov(train.to_numpy(), rowvar=False, ddof=1)
assert np.linalg.eigvalsh(covariance).min() >= -1e-12
assert np.isclose(fit.explained_variance.sum(), np.linalg.eigvalsh(covariance)[-3:].sum())
print("French snapshot: monthly published portfolio returns; not PIT prices")
print("training rows:", len(train), "features:", list(train.columns))
print("first three training EVR:", fit.explained_variance_ratio)
dropna在这里为共同样本法,舍弃任一行业缺失的整月。实际研究应报告舍弃月份及原因,而不只报告最终行数;本例明确检验固定窗口行数,不允许悄悄缩成不同样本后沿用原结论。不要把未中心化的价格水平做PCA后,直接解释成收益风险因子。
12. Common Mistakes
12.1 维度合法,但证券顺序错了
两个权重与两个收益相乘不会报错,但资产A、B互换后经济含义改变。可运行对照:
import numpy as np
import pandas as pd

returns = pd.Series({"A": 0.02, "B": -0.01})
weights = pd.Series({"B": 0.4, "A": 0.6})
wrong = float(returns.to_numpy() @ weights.to_numpy())
correct = float(returns @ weights.reindex(returns.index))
assert np.isclose(wrong, 0.002)
assert np.isclose(correct, 0.008)
print("positional mistake:", wrong, "aligned labels:", correct)
数组操作前冻结并核对列清单;训练、风险模型、持仓和执行系统必须用同一证券映射。第3章的永久证券ID并不能自动保证矩阵列顺序。
12.2 把“两两都合理”当成整体合理
12.3 solve成功就宣布组合有效
线性方程的残差很小,可能只是数值算法准确。预算、杠杆、行业约束、卖空与成本完全是另外的条件。不要把8.3的线性解直接当成最大夏普组合;还没有定义无风险收益、预算归一化或可行集合(Feasible Set)。
12.4 在全样本拟合PCA,再切训练和测试
这会让训练特征依赖未来均值和协方差。即使PCA没有标签,也发生前处理泄漏(Preprocessing Leakage)。要在每个训练窗口内拟合,并对下一窗口只做变换。第18节通过改变未来极端行证明训练均值应该不受影响。
12.5 混用标准化与风险单位
价格、美元成交额、百分数收益、基点收益放进同一矩阵后,方差大的量可能只是单位更大。标准化(Standardization)改变每列尺度,可能有助于特征比较,却也会抹去资产风险量级。做协方差风险PCA还是相关PCA,取决于问题;不能先随意缩放,后来仍按原收益单位解释。
12.6 逐个比较主成分符号或重根方向
同一方向乘以−1仍是同一个方向。两个近似相等的特征值可能使对应单个向量对小扰动敏感,而它们张成的子空间较稳定。测试应检查投影子空间、正交性、重构和谱;不要把“每个载荷符号完全一样”当作唯一正确答案。
13. Quant Research Application
现在可以制定一个风险面板实验:选定币种、频率、收益区间和资产清单,取仅在训练截止之前可得的版本,统一缺失规则,然后估计同一完整样本的协方差。先检查对称性、单位、最小特征值、秩和条件数,再评价候选权重的方差。
若要使用PCA,训练窗口拟合均值与方向,把下一窗口仅投影到过去方向上;保存中心、方向、特征次序、训练截止、版本和随机配置。换窗口后比较主子空间,而不只比较方向符号。第19章动态模型与第41章降维会接着讨论结构变化。
至少设两个反证条件:若主方向对很小样本扰动就大幅变动,模型可能不适合稳定配置;若高方差解释率不能改善样本外风险预测或下游任务,不能把它包装成研究优势。基准可用等权、单一共同风险方向或已有经济因子,而不是只拿更复杂的模型彼此比较。
该实验的本章输出是风险结构和数值诊断,不是投资业绩。回测需要信号、执行、持仓、费用和标签时间,第29章完整实现;在这里先把矩阵对象交给下一阶段,保留能复查的中间结果。
14. Chapter Summary
向量、矩阵和转置把同时处理多资产的问题写成有形状的映射。秩判断独立方向数,可逆性决定某些方程能否唯一求解,条件数提醒你误差可能被放大。正交、投影和换基帮助解释回归与风险分解。
给定权重的组合方差是
本章的下一步有三条:第6章把期望与协方差放回概率框架;第8章把投影用于回归估计;第9、20、21章在估计和约束下决定投资权重。先读懂矩阵,不必先找到“最优策略”。
15. Exercises
5-E01:一个收益面板有120个月、10个行业。写出
5-E02:用权重
5-E03:解释“秩为1”与“只有1列”的区别。对
5-E04:给一个PSD但非PD的协方差矩阵,找出方差为零的非零组合方向。再说明“PSD”为什么不保证每个资产都彼此独立。
5-E05:使用8.1的年度
5-E06:若中心化样本有
5-E07:8.4的三行样本用第一主成分保留100%方差。若方向整体反号,得分、重构、解释方差分别怎样变化?这能否证明对未来目标有预测能力?
5-N01 识别与维度:两期收益面板
5-N02 手算:计算
5-N03 代码诊断:下面代码能运行,但它输出的是什么?把它改成按日期算组合收益,并用断言验证结果。
import numpy as np

returns = np.array([[0.02, -0.01], [-0.03, 0.04]])
weights = np.array([0.6, 0.4])
wrong = (returns * weights).sum(axis=0)
print(wrong)
5-N04 研究判断:研究者把十只资产的全时期价格水平直接组成矩阵,先用全时期均值中心化,再做PCA。他把解释方差最高的方向叫作“市场收益因子”,把它当交易信号,并用“解释了大部分方差”证明策略有效。指出至少三处对象、尺度或时间上的问题,写出训练/留出流程,并说明怎样的证据才支持交易主张。
16. Programming Exercises
5-P01:写程序诊断给定实方阵:检查形状、有限值、对称性;对称时输出特征值与尺度相关的PSD判断;输出秩和条件数。用
5-P02:用共同完整训练矩阵实现中心化协方差;调用共享pca_fit_transform,核对全成分重构、成分正交、各得分方差与解释方差对应。截断到一根方向后计算平方重构误差,并与舍弃的奇异值平方和对照。
5-P03:拟合四行训练样本,再变换一行未来样本。把未来样本改成极端值,确认训练均值与方向不变;展示错误全样本拟合的均值发生变化。记录特征次序,拒绝未来矩阵列数不匹配。程序不能依赖此前Notebook单元的变量。
17. Challenge Problems
5-C01:构造两只近乎重复的资产,协方差为
5-C02:你用真实French行业月收益做PCA,第一主成分解释较高方差。同事说“第一主成分就是市场因子;保留它一定提高策略夏普”。设计一份反证计划:经济命名、时间版本、样本外、特征缩放、风险与费用分别检查什么?给出无法支持该说法的条件。
18. Solutions / Solution Hints
18.1 概念与手算
5-E01解答。
5-E02解答。 正确内积为
5-E03解答。 列数是存储维度,秩是独立方向数。矩阵有两列,但第二列为第一列2倍,所以秩1。
5-E04解答。 可取
5-E05解答。 期望收益
5-E06解答。 中心化后秩至多
5-E07解答。
18.2 编程参考实现
5-P01参考解。 容差按特征值尺度计算,它用于诊断数值误差,不会把较大的负方向自动删掉。报告psd_numerical与最小特征值,保留阈值让读者可复查。实对称PSD矩阵未必可逆,故诊断与求解分开。
import numpy as np

def diagnose_symmetric_matrix(matrix, relative_tolerance: float = 1e-10) -> dict:
    raw = np.asarray(matrix)
    if raw.ndim != 2 or raw.shape[0] != raw.shape[1] or raw.shape[0] == 0:
        raise ValueError("require a non-empty square matrix")
    if not np.issubdtype(raw.dtype, np.number) or np.iscomplexobj(raw):
        raise TypeError("require real numeric values")
    values = raw.astype(float)
    if not np.isfinite(values).all():
        raise ValueError("require finite values")
    if not np.isfinite(relative_tolerance) or relative_tolerance <= 0:
        raise ValueError("tolerance must be positive and finite")
    scale = max(float(np.linalg.norm(values, ord=2)), np.finfo(float).tiny)
    if not np.allclose(values, values.T, rtol=relative_tolerance,
                       atol=relative_tolerance * scale):
        raise ValueError("input is not symmetric; do not silently symmetrize")
    eigenvalues = np.linalg.eigvalsh(values)
    tolerance = relative_tolerance * scale
    return {"eigenvalues": eigenvalues, "tolerance": tolerance,
            "psd_numerical": bool(eigenvalues.min() >= -tolerance),
            "pd_numerical": bool(eigenvalues.min() > tolerance),
            "rank": int(np.linalg.matrix_rank(values)),
            "condition_2": float(np.linalg.cond(values))}

covariance = np.array([[0.04, 0.01], [0.01, 0.09]])
singular = np.array([[1.0, 2.0], [2.0, 4.0]])
invalid = np.array([[1.0, 0.9, 0.9], [0.9, 1.0, -0.9], [0.9, -0.9, 1.0]])
assert diagnose_symmetric_matrix(covariance)["pd_numerical"]
assert diagnose_symmetric_matrix(singular)["psd_numerical"]
assert not diagnose_symmetric_matrix(singular)["pd_numerical"]
assert not diagnose_symmetric_matrix(invalid)["psd_numerical"]
assert np.isclose(diagnose_symmetric_matrix(invalid)["eigenvalues"][0], -0.8)
print(diagnose_symmetric_matrix(covariance))
“数值正定”依赖尺度与阈值,不应替代精确数学定义。输入只是稍微不对称时也应追查形成原因,再按显式规则处理;这份教学函数直接拒绝。
5-P02参考解。 全成分检查的是样本重构与方差口径,单成分检查的是截断误差。平方误差为弗罗贝尼乌斯范数(Frobenius Norm)的平方:
import numpy as np
from quant_course.math_tools import pca_fit_transform

samples = np.array([[1.0, 2.0, 0.0], [2.0, 0.0, 1.0],
                    [4.0, 3.0, 2.0], [3.0, 5.0, 1.0]])
full = pca_fit_transform(samples, n_components=3)
centered = samples - full.center
covariance = centered.T @ centered / (len(samples) - 1)
assert np.allclose(full.projection @ full.components + full.center, samples)
assert np.allclose(full.components @ full.components.T, np.eye(3))
assert np.allclose(np.var(full.projection, axis=0, ddof=1), full.explained_variance)
assert np.isclose(full.explained_variance.sum(), np.trace(covariance))
short = pca_fit_transform(samples, n_components=1)
reconstructed = short.projection @ short.components + short.center
squared_error = float(np.square(samples - reconstructed).sum())
singular_values = np.linalg.svd(centered, compute_uv=False)
assert np.isclose(squared_error, np.square(singular_values[1:]).sum())
print("discarded reconstruction error:", squared_error)
若数据列单位不一致,平方重构误差会被大尺度列主导;这个数值目标本身仍然可计算,但其研究意义必须另行判断。
5-P03参考解。 变换函数按已拟合方向与均值计算,不更新参数。它只能核对列数,证券名称须由调用方另保存与核对;生产版本还应把列清单作为模型元数据。
import numpy as np
from quant_course.math_tools import pca_fit_transform

training = np.array([[0.01, -0.02], [0.02, 0.01],
                     [-0.01, 0.03], [0.0, -0.01]])
future = np.array([[0.03, 0.02]])
fit = pca_fit_transform(training, n_components=2)
saved_center = fit.center.copy()
saved_components = fit.components.copy()

def transform_past_fit(values, center, components):
    array = np.asarray(values, dtype=float)
    if array.ndim != 2 or array.shape[1] != len(center):
        raise ValueError("feature count differs from training")
    if not np.isfinite(array).all():
        raise ValueError("non-finite future features")
    return (array - center) @ components.T

scores = transform_past_fit(future, fit.center, fit.components)
changed_future = np.array([[100.0, -100.0]])
changed_scores = transform_past_fit(changed_future, fit.center, fit.components)
assert not np.allclose(scores, changed_scores)
assert np.array_equal(fit.center, saved_center)
assert np.array_equal(fit.components, saved_components)
leaky_fit = pca_fit_transform(np.vstack([training, changed_future]), n_components=2)
assert not np.allclose(leaky_fit.center, saved_center)
try:
    transform_past_fit(np.zeros((1, 3)), fit.center, fit.components)
except ValueError:
    pass
else:
    raise AssertionError("mismatched feature count accepted")
print("past center:", fit.center, "leaky center:", leaky_fit.center)
这项检查证明极端未来输入没有改动本次拟合参数;它没有自动证明所有调用都只传入过去数据。调用者仍需执行时间切分,持久化训练截止与版本。
18.3 挑战题参考论证与评分
5-C01参考解。 矩阵的共同方向
import numpy as np

covariance = 0.04 * np.array([[1.0, 0.999], [0.999, 1.0]])
first = np.linalg.solve(covariance, np.array([0.05, 0.05]))
second = np.linalg.solve(covariance, np.array([0.051, 0.049]))
assert np.isclose(np.linalg.cond(covariance), 1999.0)
assert np.allclose(second - first, [25.0, -25.0])
print(first, second)
处理办法应覆盖三层:数据层检查资产是否重复、收益是否同步、共同样本是否太短;估计层评估预期收益收缩与协方差正则化,记录引入的偏差;决策层用预算、杠杆、个股界限和换手费用约束可实施持仓。算法层继续用稳定分解与残差诊断,但不能用它代替前三层。评分10分:主方向与特征值3分,数值解与放大机制3分,三层处理3分,明确不视作套利证明1分。
5-C02参考解。 先比较第一方向得分与独立定义的市场超额收益,注明频率、币种和模型;高相关也不能把两个对象宣称相同。记录行业序列当前下载版本和收益月份,区分回溯分析与真正PIT交易实验;当前修订快照不足以复现当时信息。
预处理只在每个训练窗口估计;比较协方差PCA、相关PCA与简单经济基准,预先定义下游预测或风险损失。下一窗口评价方向稳定性、风险预测误差与预测目标,而不是重用训练解释率。若最终形成投资策略,还要补上可交易资产映射、预算、实际成交延迟、费用和净收益评价。若改进只在样本内、不同尺度下方向大幅改变、极少数年份驱动结论,或净费用后未改善,就不能支持同事的强说法。
评分10分:经济命名与比较2分,版本时间2分,训练与样本外2分,尺度及稳定性2分,投资约束/费用与明确反证2分。只写“PCA降维所以模型更好”不给方法分。
18.4 本轮新增题完整解答
5-N01解答。
5-N02解答。
每格取左矩阵一行、右矩阵一列。若交换,必须重新核对维度与含义;本例两矩阵恰为方阵,反向乘法虽有定义,但输出会是
5-N03解答。 错误代码沿axis=0把不同日期加起来,返回每个资产的合计加权收益:
这两个数按资产汇总,不是每期组合收益。逐期聚合应沿资产列,也可直接做矩阵乘法:
import numpy as np

returns = np.array([[0.02, -0.01], [-0.03, 0.04]])
weights = np.array([0.6, 0.4])
by_date = (returns * weights).sum(axis=1)
via_matrix = returns @ weights
assert by_date.shape == (2,)
assert np.allclose(by_date, [0.008, -0.002])
assert np.allclose(via_matrix, by_date)
assert np.allclose((returns * weights).sum(axis=0), [-0.006, 0.012])
axis=1把每行的A、B两项相加,保留两个日期;@按定义也逐行计算内积。断言核对形状、手算结果和错误轴的输出。
5-N04解答。 价格水平不是收益,主成分方向只能描述输入价格矩阵的变化,不能直接命名成收益因子。全时期中心化让留出期参与了拟合;不同价格尺度也会影响协方差PCA的方向。高解释方差只说明训练数据在该方向上变化较大,不说明它预测收益、能成交或扣费后获利。
先明确研究对象与资产顺序,再从当时可得价格构造同频收益;按时间划分训练和留出窗口。只用训练收益估计中心;若研究问题需要标准化,再用训练标准差缩放。训练PCA拟合出的方向、中心、列顺序和截止时间要冻结,留出收益只使用这些参数计算得分。最后预先定义风险预测或交易目标,与简单基准比较,在后续时间窗评估稳定性;交易主张还需可交易映射、执行时点、费用和净表现证据。若只有训练解释率,没有这些样本外结果,就不支持策略有效的结论。
19. Further Reading
- Must Know:MIT OCW 18.06课程与大纲。按线性方程、向量空间、正交投影、特征值与正定矩阵的顺序补基础题;不要只看最后的SVD。
- Should Know:NumPy SVD、solve、eigh。先检查输出形状、方向存储方式与返回顺序,再替换教学手算。
- Should Know:scikit-learn PCA。核对中心化、不自动逐列缩放、成分方向与解释方差;读不同求解器条件,不把默认API等同唯一统计定义。
- Advanced:第21章协方差收缩与约束,第41章PCA、聚类和状态识别。进入它们前先能解释本章的PSD、样本秩与训练内拟合。
20. References
本章数学推导和小例子为原创教学表达,来源用于核对课程范围与技术定义;不是对某本教材逐页改写。核验日期为2026-10-05,具体读取范围与边界见source_notes.md。
- MIT_LA / MIT_LA_SYLL:MIT OCW 18.06 Linear Algebra、Syllabus。课程范围包括线性方程、向量空间、正交、特征值与正定矩阵;本章未声称逐份读取视频和讲义。
- NP_SVD:numpy.linalg.svd。核对分解、紧凑形状、奇异值排序及重构关系。
- NP_EIGH:numpy.linalg.eigh。核对实对称输入、列方向、升序特征值与三角部分约定。
- NP_SOLVE / NP_COND:numpy.linalg.solve、numpy.linalg.cond。核对线性系统、满秩方阵条件、异常与二范数条件数。
- SK_PCA:scikit-learn PCA API。核对中心化及尺度、成分与方差属性;本章共享实现使用显式SVD,没有声称依赖在线文档所示版本的全部默认行为。
- FRENCH_10:Detail for 10 Industry Portfolios。真实缓存来源与hash见data manifest。行业组合收益不等于逐股行情或实际可成交组合。